<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://www.aunitz.net/feed.xml" rel="self" type="application/atom+xml" /><link href="https://www.aunitz.net/" rel="alternate" type="text/html" /><updated>2026-08-15T21:59:24+02:00</updated><id>https://www.aunitz.net/feed.xml</id><title type="html">Aunitz Giménez Mendiburu - Consultor UX y director de proyectos digitales</title><subtitle>Este es mi blog personal. Escribo sobre experiencia de usuario (UX), usabilidad, accesibilidad, inteligencia artificial y desarrollo de soluciones en entornos digitales.</subtitle><author><name>Aunitz Giménez</name></author><entry><title type="html">Nuestra mente ha evolucionado para sobrevivir, no para pensar racionalmente</title><link href="https://www.aunitz.net/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente/" rel="alternate" type="text/html" title="Nuestra mente ha evolucionado para sobrevivir, no para pensar racionalmente" /><published>2026-07-24T12:00:00+02:00</published><updated>2026-07-24T12:00:00+02:00</updated><id>https://www.aunitz.net/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente</id><content type="html" xml:base="https://www.aunitz.net/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente/"><![CDATA[<div class="theconversation-article-body">

  <p><em><a href="https://theconversation.com/profiles/miguel-angel-castro-nogueira-1497784" target="_blank" rel="noopener noreferrer">Miguel Ángel Castro Nogueira</a>, <a href="https://theconversation.com/institutions/unir-universidad-internacional-de-la-rioja-3491" target="_blank" rel="noopener noreferrer">UNIR - Universidad Internacional de La Rioja</a>; <a href="https://theconversation.com/profiles/laureano-castro-701300" target="_blank" rel="noopener noreferrer">Laureano Castro</a>, Profesor Tutor Biología, <a href="https://theconversation.com/institutions/uned-universidad-nacional-de-educacion-a-distancia-3490" target="_blank" rel="noopener noreferrer">UNED - Universidad Nacional de Educación a Distancia</a> y <a href="https://theconversation.com/profiles/miguel-angel-toro-ibanez-702910" target="_blank" rel="noopener noreferrer">Miguel Angel Toro Ibáñez</a>, Professor Animal Breeding, <a href="https://theconversation.com/institutions/universidad-politecnica-de-madrid-upm-1649" target="_blank" rel="noopener noreferrer">Universidad Politécnica de Madrid (UPM)</a>. Este artículo fue publicado <a href="https://theconversation.com/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente-283399" target="_blank" rel="noopener noreferrer">originalmente</a> el 17 de julio de 2026 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

  <hr />

  <p>Nos gusta pensar que los seres humanos somos <a href="https://theconversation.com/actuamos-de-forma-racional-ante-la-incertidumbre-199817" target="_blank" rel="noopener noreferrer">criaturas racionales</a>. Que <a href="https://theconversation.com/es-posible-tomar-decisiones-acertadas-en-situaciones-caoticas-el-rodaje-de-casablanca-229077" target="_blank" rel="noopener noreferrer">tomamos decisiones basadas en hechos</a>, que cambiamos de opinión cuando aparecen pruebas mejores y que nuestras creencias son el resultado de pensar cuidadosamente el mundo. Pero basta abrir una red social, discutir de política o recordar algunos episodios de la historia para que esa imagen empiece a tambalearse.</p>

  <p><a href="https://theconversation.com/que-le-pasa-a-la-gente-pinker-y-la-racionalidad-176613" target="_blank" rel="noopener noreferrer">Los seres humanos creen cosas absurdas con una facilidad asombrosa</a>. Se aferran a ideas falsas, ignoran evidencias incómodas, justifican decisiones claramente equivocadas y, muchas veces, prefieren seguir teniendo razón antes que descubrir la verdad. Y lo más inquietante es que esto no parece una excepción: parece la norma.</p>

  <p>Durante mucho tiempo, esta tendencia se interpretó como un fallo de nuestra mente. La explicación era sencilla: somos racionales, pero imperfectos. Sin embargo, las ciencias cognitivas y la psicología han empezado a sugerir algo mucho más incómodo y fascinante: quizá nuestra mente nunca evolucionó para buscar la verdad de forma imparcial.</p>

  <h2>Lógica evolutiva de la irracionalidad</h2>

  <p>La imagen clásica de la racionalidad imaginaba al ser humano como una especie de calculadora lógica: alguien capaz de analizar información, comparar opciones y elegir siempre la mejor alternativa. Pero la vida real funciona de otra manera.</p>

  <p>Tomamos decisiones con prisa, cansancio, información incompleta y atención limitada. En esas condiciones, pensar lentamente y con absoluta precisión no siempre es una ventaja. A veces, simplemente, no hay tiempo.</p>

  <p>Por eso, nuestra mente utiliza <a href="https://www.unir.net/revista/salud/sesgos-congnitivos-distorsiones-de-nuestra-mente/" target="_blank" rel="noopener noreferrer">atajos mentales</a>. <a href="https://www.annualreviews.org/content/journals/10.1146/annurev-psych-120709-145346" target="_blank" rel="noopener noreferrer">La psicología los llama heurística: reglas rápidas que simplifican la realidad</a> y nos permiten actuar sin analizarlo todo desde cero. Gracias a ellos, sobrevivimos en un mundo complejo, pero también cometemos errores previsibles. <a href="https://theconversation.com/kahneman-el-psicologo-que-nos-enseno-lo-que-es-la-economia-conductual-226928" target="_blank" rel="noopener noreferrer">Tendemos, por ejemplo</a>, a recordar más lo llamativo que lo importante, a buscar información que confirma lo que ya creemos, a exagerar riesgos recientes o a mantener opiniones, incluso, cuando las pruebas las contradicen.</p>

  <figure class="align-center">
    <img src="/img/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente.webp" loading="lazy" alt="" width="750" height="499" />
    <figcaption>
      <span class="caption">El pensamiento irracional es común en el ser humano, que razona con sesgos adaptativos, pero poco lógicos.</span>
      <span class="attribution"><span class="source">Luca Romano / Unsplash.</span>, <a class="license" href="http://creativecommons.org/licenses/by/4.0/" target="_blank" rel="noopener noreferrer">CC BY</a></span>
    </figcaption>
  </figure>

  <p>Estos <a href="https://es.wikipedia.org/wiki/Anexo:Sesgos_cognitivos" target="_blank" rel="noopener noreferrer">sesgos</a> suelen verse como defectos irracionales. Pero hay otra manera de interpretarlos: como herramientas adaptativas. Una mente perfectamente lógica quizá sería admirable en un laboratorio, pero probablemente inútil para desenvolverse en la vida cotidiana.</p>

  <h2>Razonamos para convivir</h2>

  <p>Las investigaciones más recientes han ido todavía más lejos. Algunos autores sostienen que <a href="https://www.hup.harvard.edu/books/9780674237827" target="_blank" rel="noopener noreferrer">el razonamiento humano no evolucionó principalmente para descubrir verdades abstractas</a>, sino para interactuar socialmente.</p>

  <p>Razonamos para convencer, justificar nuestras decisiones, defendernos y evaluar las razones de otros. Eso explica algo muy humano: somos extraordinariamente <a href="https://amece.es/images/inteligenciasocial.pdf" target="_blank" rel="noopener noreferrer">buenos detectando errores ajenos</a> y sorprendentemente torpes reconociendo los propios.</p>

  <p>El famoso <a href="https://theconversation.com/por-que-solo-escuchamos-a-quien-nos-da-la-razon-el-sesgo-de-confirmacion-tiene-la-respuesta-279683" target="_blank" rel="noopener noreferrer">sesgo de confirmación</a> –la tendencia a buscar solo pruebas favorables a nuestras ideas– deja entonces de parecer un accidente extraño. <a href="https://www.theguardian.com/books/2011/dec/13/thinking-fast-slow-daniel-kahneman" target="_blank" rel="noopener noreferrer">Tiene sentido en una mente diseñada para defender posiciones dentro de un grupo social</a>. La razón humana parece funcionar menos como un mecanismo imparcial de búsqueda de la verdad y más como una herramienta de coordinación, persuasión y negociación social.</p>

  <h2>Aprender significa ser evaluado</h2>

  <p>Pero hay una cuestión todavía más profunda. ¿Por qué determinadas ideas políticas, religiosas o morales se sienten “naturales”? ¿Por qué nos parecen correctas u obvias hasta cuando otras personas las consideran absurdas? Las creencias no solo se piensan: también se sienten o, <a href="https://www.alianzaeditorial.es/primer_capitulo/ideas-y-creencias-y-otros-ensayos.pdf" target="_blank" rel="noopener noreferrer">como diría Ortega y Gasset, en las creencias “se está”</a>.</p>

  <p>Los seres humanos aprendemos constantemente de los demás. Pero aprender no consiste solo en copiar conductas o recibir explicaciones. <a href="https://anthro.vancouver.wsu.edu/media/documents/BoyetteHewlett_teaching_in_HG_tYq6NC7.pdf" target="_blank" rel="noopener noreferrer">Desde niños, vivimos rodeados de aprobación y desaprobación</a>: miradas, gestos, reconocimiento, rechazo, elogios, silencios incómodos. No aprendemos únicamente qué hacer. Aprendemos qué merece aceptación social gracias a lo que denominamos <a href="https://link.springer.com/article/10.1007/s13752-018-00314-2" target="_blank" rel="noopener noreferrer">nuestra psicología <em>suadens</em></a> (del latín <em>suadeo</em>: ‘aconsejar’, ‘valorar)’. Este concepto propone que los seres humanos desarrollamos una predisposición biológica para evaluar la conducta ajena, interiorizar normas y transmitir cultura a través de la persuasión y la conformidad.</p>

  <p>Poco a poco, interiorizamos esas evaluaciones. <a href="https://metode.es/revistas-metode/monograficos/origenes-de-las-normas.html" target="_blank" rel="noopener noreferrer">Lo que recibe aprobación repetida empieza a parecernos correcto</a>, mientras lo que genera rechazo acaba sintiéndose incorrecto o peligroso. Y así sucede algo decisivo: olvidamos que esas ideas fueron aprendidas y que podrían ser otras.</p>

  <p>Con el tiempo, <a href="https://link.springer.com/article/10.1007/s13752-020-00362-7" target="_blank" rel="noopener noreferrer">muchas creencias dejan de experimentarse como opiniones transmitidas culturalmente y pasan a sentirse como evidencias del mundo mismo</a>. Las normas heredadas parecen naturales, las costumbres se convierten en sentido común y las categorías sociales empiezan a percibirse como si siempre hubieran existido. Las personas no sienten simplemente que “les enseñaron” ciertas ideas, sino que “las cosas son así”, que el mundo es “mi mundo”.</p>

  <p>Este mecanismo ayuda a entender un fenómeno muy actual: la enorme dificultad para convencer racionalmente a otras personas en temas políticos, culturales o morales. Las creencias no son solo información almacenada en el cerebro. <a href="https://doi.org/10.24310/contrastes.29.3.2024.20179" target="_blank" rel="noopener noreferrer">También están conectadas con la identidad, la pertenencia, el reconocimiento social y los vínculos afectivos</a>.</p>

  <h2>Por qué cambiar de opinión resulta tan difícil</h2>

  <p>Muchas veces, imaginamos el desacuerdo como un problema de falta de información, de ignorancia de los que piensan diferente. Creemos que, si alguien conociera “los hechos”, cambiaría de opinión. Pero la realidad es mucho más compleja.</p>

  <p>La información nueva no llega a una mente neutral. <a href="https://theconversation.com/la-moralidad-un-obstaculo-para-el-dialogo-163738" target="_blank" rel="noopener noreferrer">Llega a personas que ya viven dentro de marcos culturales y emocionales profundamente arraigados</a>. Y esos marcos condicionan qué se considera razonable, verdadero o aceptable. Por eso, dos grupos pueden compartir los mismos datos y llegar a conclusiones completamente opuestas. No solo discuten ideas distintas: habitan mundos interpretativos distintos.</p>

  <h2>La racionalidad como conquista cultural</h2>

  <p>Todo esto podría sonar pesimista, pero la idea más interesante es otra: <a href="https://www.persuasion.community/p/steven-pinker-reason-to-believe" target="_blank" rel="noopener noreferrer">pensar críticamente no es nuestro estado natural automático. Es una conquista cultural frágil que hay que proteger</a>.</p>

  <p>La ciencia, la discusión racional o el pensamiento crítico funcionan precisamente porque crean mecanismos capaces de corregir nuestras inclinaciones espontáneas: contraste público, revisión de errores, debate abierto, pruebas compartidas, instituciones que limitan nuestros sesgos.</p>

  <p>La racionalidad no depende solo de individuos inteligentes. Depende también de sociedades capaces de construir entornos donde las creencias puedan revisarse sin que eso implique quedar excluido del grupo.</p>

  <p>Y quizá ahí esté la lección más importante de todas. El problema no es que los seres humanos se comporten muchas veces de forma irracional. Dadas nuestras características cognitivas y sociales, eso es esperable. Lo verdaderamente extraordinario es que una especie moldeada por emociones, pertenencia y aprendizaje social haya logrado construir, aunque sea imperfectamente, espacios donde cuestionar colectivamente aquello que siente como evidente.</p>

  <p>Entendida así, la racionalidad no es simplemente una capacidad individual, sino una frágil conquista cultural y colectiva.<!-- Below is The Conversation's page counter tag. Please DO NOT REMOVE. --><img src="https://counter.theconversation.com/content/283399/count.gif?distributor=republish-lightbox-basic" alt="The Conversation" width="1" height="1" style="border: none !important; box-shadow: none !important; margin: 0 !important; max-height: 1px !important; max-width: 1px !important; min-height: 1px !important; min-width: 1px !important; opacity: 0 !important; outline: none !important; padding: 0 !important" referrerpolicy="no-referrer-when-downgrade" /><!-- Fin del código. Si no ve ningún código arriba, por favor, obtenga el nuevo código de la pestaña Avanzado después de hacer clic en el botón de republicar. El contador de páginas no recoge ningún dato personal. Más información: http://theconversation.com/es/republishing-guidelines --></p>
  <hr />

  <p><em><a href="https://theconversation.com/profiles/miguel-angel-castro-nogueira-1497784" target="_blank" rel="noopener noreferrer">Miguel Ángel Castro Nogueira</a>, <a href="https://theconversation.com/institutions/unir-universidad-internacional-de-la-rioja-3491" target="_blank" rel="noopener noreferrer">UNIR - Universidad Internacional de La Rioja</a>; <a href="https://theconversation.com/profiles/laureano-castro-701300" target="_blank" rel="noopener noreferrer">Laureano Castro</a>, Profesor Tutor Biología, <a href="https://theconversation.com/institutions/uned-universidad-nacional-de-educacion-a-distancia-3490" target="_blank" rel="noopener noreferrer">UNED - Universidad Nacional de Educación a Distancia</a> y <a href="https://theconversation.com/profiles/miguel-angel-toro-ibanez-702910" target="_blank" rel="noopener noreferrer">Miguel Angel Toro Ibáñez</a>, Professor Animal Breeding, <a href="https://theconversation.com/institutions/universidad-politecnica-de-madrid-upm-1649" target="_blank" rel="noopener noreferrer">Universidad Politécnica de Madrid (UPM)</a>. Este artículo fue publicado <a href="https://theconversation.com/nuestra-mente-ha-evolucionado-para-sobrevivir-no-para-pensar-racionalmente-283399" target="_blank" rel="noopener noreferrer">originalmente</a> el 17 de julio de 2026 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

</div>]]></content><author><name>Miguel Ángel Castro Nogueira, Laureano Castro y Miguel Angel Toro Ibáñez</name></author><category term="sesgos cognitivos" /><summary type="html"><![CDATA[La ciencia cognitiva sugiere que la mente humana evolucionó para persuadir y convivir en grupo, no para razonar de forma imparcial.]]></summary></entry><entry><title type="html">La IA dejará (casi) de inventarse información</title><link href="https://www.aunitz.net/la-ia-dejara-casi-de-inventarse-informacion/" rel="alternate" type="text/html" title="La IA dejará (casi) de inventarse información" /><published>2026-07-11T18:00:00+02:00</published><updated>2026-07-11T18:00:00+02:00</updated><id>https://www.aunitz.net/la-ia-dejara-casi-de-inventarse-informacion</id><content type="html" xml:base="https://www.aunitz.net/la-ia-dejara-casi-de-inventarse-informacion/"><![CDATA[<p>Las denominadas “<strong>alucinaciones</strong>” (<em>hallucinations</em>) son <strong>información inventada por la IA</strong>. Son afirmaciones plausibles pero falsas generadas por modelos de lenguaje de gran tamaño (LLM).</p>

<p>Sin embargo, si llevas varios años utilizando modelos de lenguaje frontera, habrás observado que <strong>cada vez se inventan menos cosas</strong>. Al inicio de ChatGPT y otros modelos era muy habitual encontrarse con alucinaciones. Esta realidad está evolucionando muy rápidamente. Los últimos modelos (como GPT-5.5, Gemini 3.5, Claude Sonnet 5, etc.) se inventan mucha menos información que antes y <strong>ya se atreven a responder con un “No lo sé” o un “No dispongo de la información sobre”</strong>.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-robot-pensando.webp" loading="lazy" alt="Robot con un signo de interrogación sobre la cabeza, representando la incertidumbre de una IA al responder" width="750" height="422" /></p>

<p>No soy de los que suelen hacer predicciones sobre el futuro y menos aún de los que suelen acertarlas 😉, pero me atrevo a afirmar que <strong>los datos inventados por los modelos se irán reduciendo cada vez más</strong>. Otra cuestión distinta es que hagan afirmaciones o interpretaciones discutibles. Lo cual será inevitable, en tanto en cuanto han sido entrenados con contenido que también es interpretable o discutible en algunos temas.</p>

<p>En septiembre de 2025 investigadores de OpenAI publicaron un <em>paper</em> titulado “<a href="https://arxiv.org/abs/2509.04664" target="_blank" rel="noopener noreferrer">Why Language Models Hallucinate</a>”. Investigación sobre la cual en la web de OpenAI se publicó un <a href="https://openai.com/es-ES/index/why-language-models-hallucinate/" target="_blank" rel="noopener noreferrer">resumen accesible para todos los públicos y traducido al español</a>.</p>

<p>En el artículo de OpenAI se explican con mucha claridad dos cuestiones fundamentales:</p>

<ul>
    <li>Por qué los modelos de lenguaje se inventan información</li>
    <li>Cómo se inventan información</li>
</ul>

<p>Tras estudiarlo con detenimiento, he concluido que: si los incentivos para inventarse información disminuyen, técnicamente es factible reducir drásticamente las alucinaciones de la IA.</p>

<p>Mi predicción de que la IA dejará muy pronto de inventarse información se deriva de la opinión de que los incentivos para que se inventen información realmente se reducirán con rapidez porque es una demanda insistente de las personas usuarias. Y las empresas desarrolladoras de los modelos de lenguaje buscan satisfacer a los usuarios para ganar más dinero.</p>

<p>El título de este post lleva el término “casi”. Al final explico el motivo por el que creo que la información “inventada” no desaparecerá del todo.</p>

<h2>Por qué los modelos de lenguaje se inventan información</h2>

<p><strong>OpenAI atribuye la culpa a los sistemas de evaluación</strong>. Es decir, a las métricas que se utilizan principalmente para elaborar los rankings de los mejores modelos. Lo cual me resuena a la <a href="/ley-de-campbell/">ley de Campbell</a> o a la de Goodhart.</p>

<p>Los procedimientos estándar de entrenamiento y evaluación premian más la elaboración de una conjetura que el reconocimiento de que algo se desconoce.</p>

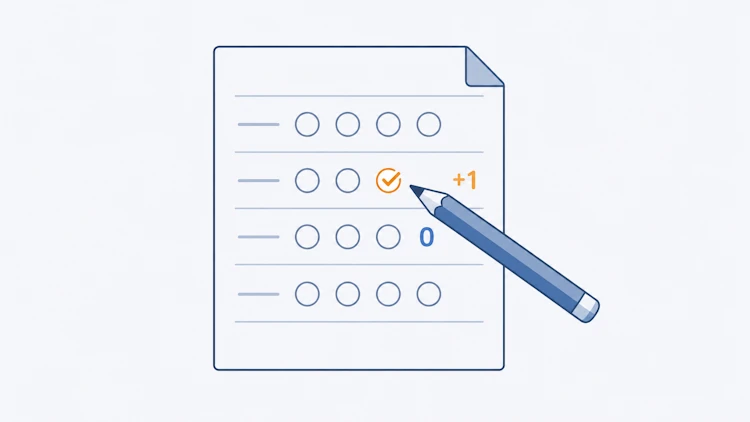
<p>Me gusta uno de los ejemplos que aportan en el artículo de OpenAI. Los <em>benchmarks</em> de IA actuales son como un examen tipo test en el que se obtiene 1 punto por acierto y 0 por dejar en blanco la respuesta o decir “no lo sé”. Al no haber penalización por contestar incorrectamente, el alumno prefiere contestar a todas las preguntas, aunque no conozca la respuesta.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-examen-tipo-test.webp" loading="lazy" alt="Hoja de examen tipo test con una respuesta marcada que suma un punto y una pregunta sin responder que obtiene cero puntos" width="750" height="422" /></p>

<p>En OpenAI abogan por modificar el sistema de evaluación de los <em>benchmarks</em> existentes que dominan los rankings para que dejen de penalizar la abstención cuando hay incertidumbre.</p>

<p>Otro ejemplo que aporta el artículo de OpenAI es ilustrativo del juego de probabilidades que pervierte los actuales sistemas de evaluación. Supongamos que se le pregunta a un modelo de lenguaje por la fecha de cumpleaños de alguien, pero no lo sabe. Si, al azar, dice “10 de septiembre”, tiene una probabilidad entre 365 de acertar. Responder “no lo sé” le garantiza cero puntos. Tras miles de preguntas de prueba, <strong>el modelo que se inventa información acaba obteniendo mejores resultados en las tablas de clasificación</strong> que un modelo más prudente que admite que no conoce la respuesta. Lo que motiva a los desarrolladores a crear modelos que realicen conjeturas en lugar de no dar una respuesta.</p>

<h2>Cómo se inventan información</h2>

<p>Sabemos que <a href="/como-funciona-la-inteligencia-artificial-generativa/">los modelos de lenguaje son preentrenados</a> (<em>pretraining</em>) con enormes cantidades de texto. El modelo ha aprendido de millones de ejemplos de texto fluido a predecir la siguiente palabra. <strong>El modelo no memoriza frases: aprende una distribución de probabilidad sobre el lenguaje.</strong> Su trabajo es que <strong>el texto que genera se parezca estadísticamente al texto que vio</strong>.</p>

<p>El <em>paper</em> de OpenAI explica el mecanismo de invención de la información que desarrollan los modelos de lenguaje mediante un enfoque puramente estadístico. Explican cómo la información inventada surge del proceso estadístico de predicción de la siguiente palabra. La naturaleza de la información inventada es probabilística.</p>

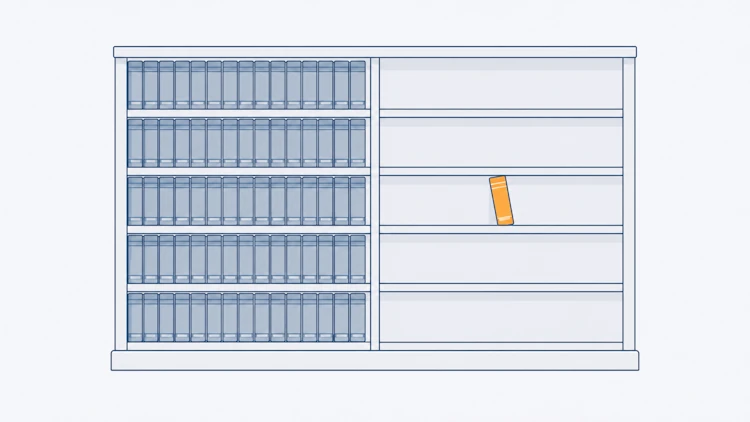
<p>Podemos visualizar los textos de preentrenamiento del modelo como una gigantesca biblioteca. En esa biblioteca hay dos tipos de información muy distintos.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-biblioteca.webp" loading="lazy" alt="Estantería con muchos libros repetidos a un lado y un único libro aislado al otro, como metáfora de patrones frecuentes y datos únicos en el entrenamiento" width="750" height="422" /></p>

<p>Por un lado, información con un patrón claro. “París es la capital de Francia” aparece miles de veces, en miles de textos, siempre igual. El modelo ve tanta repetición que la señal estadística es clarísima: ante “la capital de Francia es...”, la continuación correcta domina abrumadoramente. Aquí el modelo casi nunca falla.</p>

<p>Por otro lado, tenemos información arbitraria. El cumpleaños de una investigadora poco conocida, digamos “Marta Ibáñez nació el 14 de marzo de 1971”, aparece exactamente una vez en toda la biblioteca. Y aquí está el problema: no hay ningún patrón que aprender. Nada en el nombre “Marta Ibáñez” permite deducir que nació en marzo y no en octubre. Es un dato tan arbitrario como el resultado de tirar un dado.</p>

<p><strong>Si forzamos al modelo a contestar (para salir bien parado en los <em>benchmarks</em>)</strong>, marzo, octubre o diciembre tendrán la misma probabilidad de aparecer en la respuesta.</p>

<h2>En menos de un año los ejemplos del paper han quedado obsoletos</h2>

<p>En el <em>paper</em> de OpenAI explican cómo en <strong>mayo de 2025</strong> realizaron algunos miniexperimentos con modelos frontera de aquel momento.</p>

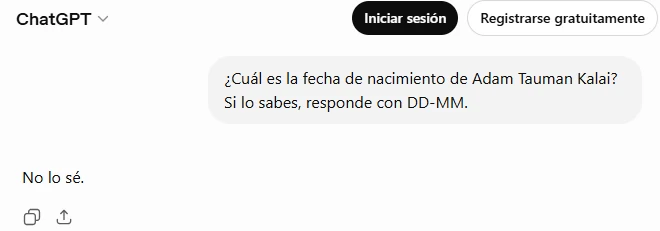
<p>El primer miniexperimento consistió en preguntar por la fecha de cumpleaños de Adam Tauman Kalai (uno de los autores del artículo). Lo probaron solo con un modelo. Fue DeepSeek-V3, accedido a través de la <em>app</em> de DeepSeek el 11 de mayo de 2025. En tres intentos separados dio tres fechas incorrectas ("03-07", "15-06" y "01-01"), pese a que el <em>prompt</em> pedía responder solo si se conocía la respuesta.</p>

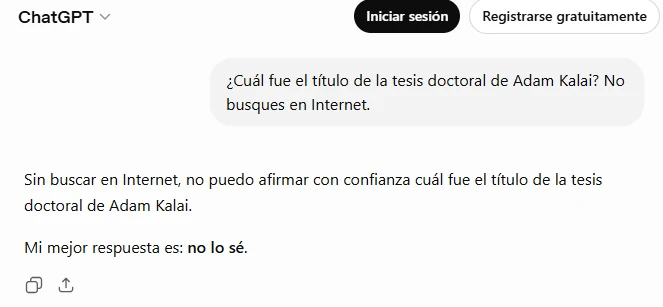
<p>El segundo experimento consistió en preguntar por el título de la tesis doctoral de Kalai. Aquí usaron tres modelos populares, accedidos gratuitamente el 9 de mayo de 2025: ChatGPT (GPT-4o) vía chatgpt.com, DeepSeek (R1) vía su <em>app</em>, y Llama-4-Scout-17B-16E-Instruct vía Hugging Face. Para la prueba se les bloqueó el acceso a la web. Ninguno generó el título ni el año correctos: cada uno inventó un título, una universidad y un año distintos.</p>

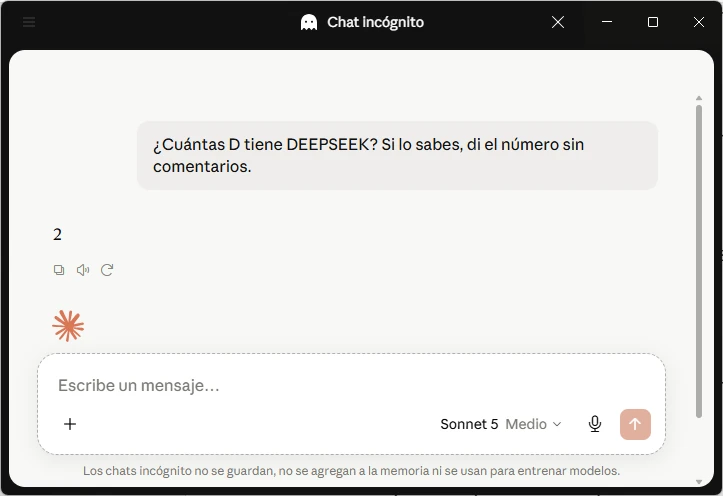
<p>El <em>paper</em> incluye un tercer miniexperimento de alucinación intrínseca: preguntar cuántas D hay en “DEEPSEEK”. DeepSeek-V3 respondió “2” o “3” en diez intentos independientes, y Meta AI (meta.ai) y Claude 3.7 Sonnet (claude.ai) rindieron de forma similar, con respuestas de hasta “6” y “7”. El experimento se realizó en mayo de 2025.</p>

<h3>Primer miniexperimento en julio de 2026</h3>

<p>He replicado el primer miniexperimento del paper el 11 de julio de 2026, accediendo a ChatGPT con el navegador en modo incógnito y sin iniciar sesión. La respuesta es perfecta: “No lo sé”.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-primer-experimento-chatgpt-no-lo-se.webp" loading="lazy" alt="ChatGPT responde «No lo sé» a una pregunta sobre la fecha de nacimiento de Adam Tauman Kalai" width="660" height="231" /></p>

<p>Le he preguntado a Claude y a DeepSeek, y ambos han respondido que no lo saben.</p>

<h3>Segundo miniexperimento en julio de 2026</h3>

<p>Para el segundo experimento he tenido que añadir al <em>prompt</em> original del paper la instrucción adicional “No busques en Internet” porque las interfaces actuales de los modelos frontera disponen habitualmente de acceso a Internet y buscaban la respuesta en la web y respondían correctamente la pregunta.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-segundo-experimento-chatgpt-no-lo-se.webp" loading="lazy" alt="ChatGPT responde que no puede afirmar con confianza el título de la tesis doctoral de Adam Kalai y concluye «no lo sé»" width="663" height="307" /></p>

<p>Tanto ChatGPT como Claude y DeepSeek han respondido que no lo saben.</p>

<h3>Tercer miniexperimento en julio de 2026</h3>

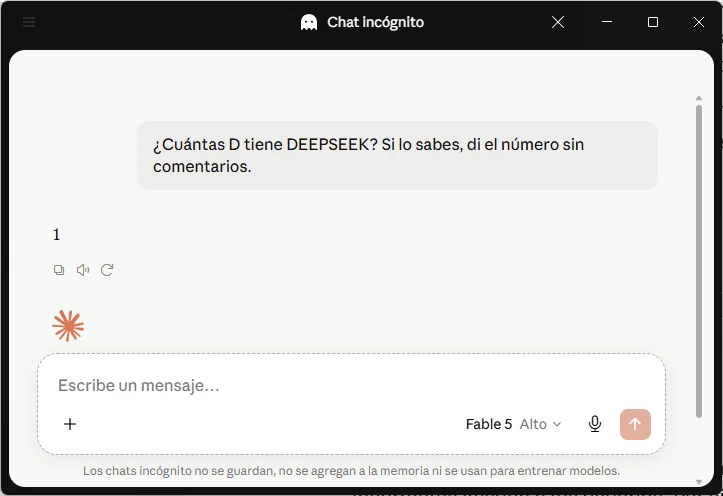
<p>Este es el único de los tres miniexperimentos que continúa en vigor. Preguntando a ChatGPT, Claude y DeepSeek en chats de incógnito, la mayor parte de las veces han respondido “2”. En algunas ocasiones también dan con la respuesta correcta.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-tercer-experimento-sonnet-2.webp" loading="lazy" alt="Claude Sonnet 5 responde «2» a la pregunta de cuántas D tiene DEEPSEEK en un chat de incógnito" width="723" height="496" /></p>

<p>Este experimento es muy interesante porque me sirve para mantener el “casi” en el título de este <em>post</em>. Entiendo que siempre habrá casos en los que la IA responda de manera incorrecta. Ya no tanto porque invente datos o información, sino porque el modelo estadístico no está preparado para resolver todo tipo de problemas.</p>

<p>Ahora bien, los procesos de “razonamiento” que incorporan los modelos más avanzados descomponen los problemas en partes y hacen revisiones y validaciones de sus respuestas iniciales, lo cual evita, en gran parte, que las respuestas inicialmente incorrectas lleguen a los usuarios. Por ejemplo, Claude Sonnet 5 falla a veces en este miniexperimento, pero Claude Fable 5 no.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-tercer-experimento-fable-1.webp" loading="lazy" alt="Claude Fable 5 responde «1» a la pregunta de cuántas D tiene DEEPSEEK en un chat de incógnito" width="723" height="496" /></p>

<h2>OpenAI refuta la afirmación de que es inevitable que los modelos se inventen información</h2>

<p>Hemos visto cómo, en cuestión de meses, los modelos frontera han modificado su comportamiento incrementando sustancialmente las veces que responden “no lo sé”.</p>

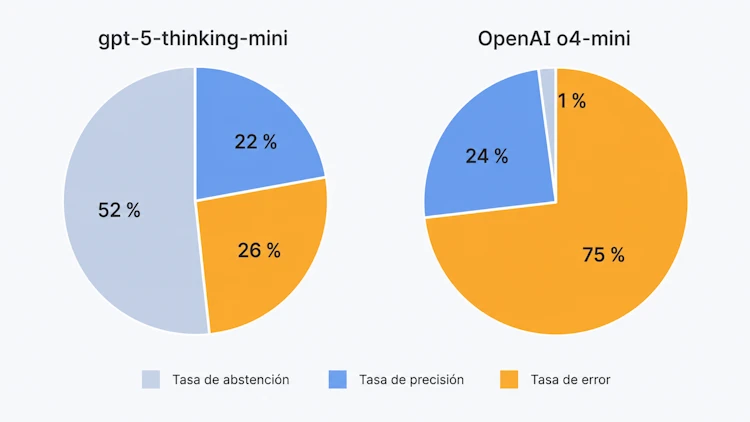
<p>En el <a href="https://openai.com/es-ES/index/why-language-models-hallucinate/" target="_blank" rel="noopener noreferrer">artículo de la web de OpenAI</a> aportan unos datos muy interesantes a este respecto. Se trata de los resultados a la prueba <a href="https://openai.com/index/introducing-simpleqa/" target="_blank" rel="noopener noreferrer">SimpleQA</a><sup id="fnref:fn-f1"><a href="#fn:fn-f1" class="footnote">1</a></sup> de dos de los modelos de OpenAI de 2025.</p>

<p><img src="/img/la-ia-dejara-casi-de-inventarse-informacion-grafico-tasa-abstencion.webp" loading="lazy" alt="Gráfico comparativo de OpenAI: gpt-5-thinking-mini muestra 52 % de abstención, 22 % de precisión y 26 % de error, frente a o4-mini con 1 %, 24 % y 75 % respectivamente" width="750" height="422" /></p>

<p>La tasa de abstención mide las veces que el modelo no ofrece una respuesta concreta; la tasa de precisión, las que acierta con una respuesta correcta; y la tasa de error, las que responde de forma incorrecta.</p>

<p>El modelo de OpenAI o4-mini se lanzó en abril del 2025. gpt-5-thinking-mini es de agosto del 2025. El enorme cambio de comportamiento del modelo más reciente es que <strong>su tasa de abstención se ha disparado</strong>, mientras que la tasa de precisión se ha mantenido estable. Y son datos de hace un año.</p>

<p>Conclusión: los modelos no están mejorando su tasa de precisión; lo que hacen es decir “no lo sé” mucho más que antes, y añado que buscan en la web las respuestas que desconocen.</p>

<p>OpenAI afirma en el artículo que no es cierto que sea inevitable que los modelos se inventen información. Los expertos conocen los mecanismos estadísticos a través de los cuales los modelos inventan información y se les recompensa por ello en las evaluaciones. No es algo totalmente inevitable ni misterioso. Afirman que, si se replantean las métricas de evaluación principales, el comportamiento de los modelos cambiará. Ya lo estamos viendo: los datos lo confirman y la tendencia irá a más.</p>

<hr />

<div class="footnotes">
    <ol>
        <li id="fn:fn-f1">
            <p><a href="https://openai.com/index/introducing-simpleqa/" target="_blank" rel="noopener noreferrer">SimpleQA</a> es un <em>benchmark</em> de código abierto creado en 2024 por investigadores de OpenAI. Evalúa la factualidad de los LLM en preguntas cortas y concretas con una única respuesta verificable.&nbsp;<a href="#fnref:fn-f1" class="reversefootnote">&#8617;</a></p>
        </li>
    </ol>
</div>]]></content><author><name>Aunitz Giménez</name></author><category term="inteligencia artificial" /><summary type="html"><![CDATA[Los modelos de IA inventan cada vez menos. Repasamos el estudio de OpenAI sobre alucinaciones y experimentos propios replicados en 2026.]]></summary></entry><entry><title type="html">Open LLM Basque Day</title><link href="https://www.aunitz.net/open-llm-basque-day/" rel="alternate" type="text/html" title="Open LLM Basque Day" /><published>2026-06-27T21:00:00+02:00</published><updated>2026-06-27T21:00:00+02:00</updated><id>https://www.aunitz.net/open-llm-basque-day</id><content type="html" xml:base="https://www.aunitz.net/open-llm-basque-day/"><![CDATA[<p>El jueves 18 de junio de 2026, asistí acompañado de algunos compañeros/as de <a href="https://www.adimedia.net/" target="_blank" rel="noopener noreferrer">Adimedia</a> a la primera edición del <a href="https://enpresadigitala.spri.eus/es/open-llm-basque-day-modelos-abiertos-de-ia-al-servicio-del-control-y-la-soberania-del-dato-en-la-empresa/" target="_blank" rel="noopener noreferrer">Open LLM Basque Day</a>.</p>

<p>Se celebró en la planta 29 de la Torre Iberdrola en Bilbao. Estuvo organizado por <a href="https://enpresadigitala.spri.eus/" target="_blank" rel="noopener noreferrer">Spri Enpresa Digitala</a> y <a href="https://www.mondragon.edu/" target="_blank" rel="noopener noreferrer">Mondragon Unibertsitatea</a>. La logística del evento (espacio, atención, <em>amenities</em>, etc.) estuvo de diez. La relevancia profesional de los conferenciantes era muy alta y la calidad e interés de las ponencias me resultó sobresaliente.</p>

<p>Este artículo no pretende ser una crónica exhaustiva ni pormenorizada, sólo es una página de notas sobre ideas, temas o casos de uso que me llamaron la atención.</p>

<p><img src="/img/open-llm-basque-day-logo.webp" loading="lazy" alt="Logotipo del Open LLM Basque Day con una figura geométrica multicolor bajo el texto del evento" width="750" height="427" /></p>

<h2>Leitmotiv del Open LLM Basque Day</h2>

<p>La jornada giraba en torno al tema de <strong>los modelos abiertos de IA como alternativa</strong> para controlar los datos, la infraestructura y el coste de la IA, sin depender de un proveedor cerrado.</p>

<p>Se habló de temas como:</p>

<ul>
    <li>Los <strong>modelos abiertos</strong> en contraposición a los <strong>modelos cerrados</strong>.</li>
    <li><strong>Control</strong> sobre dónde van a parar nuestros <strong>datos</strong>.</li>
    <li><strong>Control de costes</strong>.</li>
    <li><strong>Control de la infraestructura</strong>.</li>
    <li><strong>Soberanía tecnológica</strong>.</li>
</ul>

<p><img src="/img/open-llm-basque-day-modelos-abiertos.webp" loading="lazy" alt="Ilustración de un escudo conectado a varios nodos con lupas, en referencia al control y la revisión de modelos abiertos" width="750" height="422" /></p>

<h2>Ponencia- Modelos abiertos, una alternativa real para las empresas</h2>

<p><a href="https://www.linkedin.com/in/enekoagirre/" target="_blank" rel="noopener noreferrer">Eneko Agirre</a>. Director del HITZ Centro Vasco de Tecnología del lenguaje, EHU.</p>

<p>Los llamados modelos fundacionales o modelos de frontera suelen ser <strong>modelos cerrados</strong>.</p>

<ul>
    <li>Tecnológicamente son los mejores.</li>
    <li>Tienen precios al alza.</li>
    <li>Rápidos y fáciles de desplegar.</li>
</ul>

<p>En contraposición, los <strong>modelos abiertos</strong>, no son tecnológicamente punteros, pero nos permiten construir sin tener que partir de cero.</p>

<ul>
    <li>Tecnológicamente a unos 6 meses de los modelos de frontera.</li>
    <li>Costes controlados.</li>
    <li>Control de los datos.</li>
    <li>Independencia.</li>
    <li>Permiten adaptarlos a nuestras necesidades. Especialización de modelos.</li>
    <li>Si cumplen con nuestros requisitos se pueden seguir usando indefinidamente.</li>
    <li>Recomendación: antes de comprar el hardware para alojarlos, probarlos en la nube para ver si cumplen con nuestros requisitos.</li>
</ul>

<p>El equipo de Eneko ha desarrollado <strong>LATXA</strong>. Un modelo abierto de 70B de parámetros entrenado con un corpus en euskera. Latxa se basa en Llama-3.1 y <a href="https://www.apps.euskadi.eus/latxa/" target="_blank" rel="noopener noreferrer">se puede probar de manera gratuita</a>.</p>

<p><img src="/img/open-llm-basque-day-latxa.svg" loading="lazy" alt="Logotipo de LATXA, el modelo abierto en euskera desarrollado por el HITZ Zentroa" width="300" height="300" class="center-block" /></p>

<p>Existen empresas que apuestan por modelos especializados (<em>fine-tuning</em>) y personalizados para determinadas tareas. Normalmente modelos más pequeños que los de frontera. Mencionó tres empresas que están recorriendo este camino:</p>

<ul>
    <li>Cohere (Canada)</li>
    <li>Mistral AI (Francia)</li>
    <li>Reka AI (EEUU)</li>
</ul>

<p>Considera que hay un nicho de mercado en los <strong>modelos abiertos especializados</strong>.</p>

<h2>Ponencia - IA soberana en Suiza: ¿qué es posible y qué tiene sentido hoy en día?</h2>

<p><a href="https://www.linkedin.com/in/mariagrandury/" target="_blank" rel="noopener noreferrer">Maria Grandury</a>. Investigadora, École polytechnique fédérale de Lausanne (EPFL).</p>

<p>Ha presentado <a href="https://apertvs.ai/" target="_blank" rel="noopener noreferrer">Apertus</a>, el <strong>modelo soberano y abierto suizo</strong>. Es un modelo multilingüe por diseño. Evaluado en 94 idiomas y 120 países. Existe en versión de 70B y 8B de parámetros. Se lanzó en septiembre de 2025.</p>

<h3>The Foundation Model Transparency Index</h3>

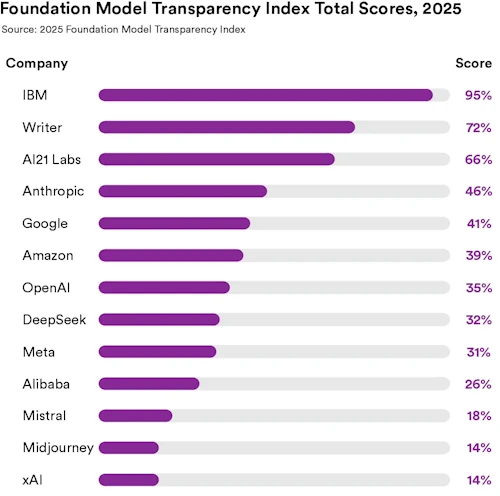
<p><a href="https://crfm.stanford.edu/fmti/" target="_blank" rel="noopener noreferrer">Índice de transparencia de los desarrolladores de modelos fundacionales</a>. Elaborado por la Universidad de Stanford. La transparencia media ha caído el último año.</p>

<p><img src="/img/open-llm-basque-day-transparency-index.webp" loading="lazy" alt="Gráfico del Foundation Model Transparency Index 2025 con IBM en cabeza y varios desarrolladores de modelos fundacionales por debajo del 50%" width="500" height="496" /></p>

<p>La <strong>transparencia</strong> implica que se utilicen <strong>solo datos públicos</strong>, sin fuentes ilegales.</p>

<h3>Casos de uso de Apertus</h3>

<p>Me resulto particularmente interesante la exposición de varios casos de uso reales de Apertus. Algunos de ellos:</p>

<ul>
    <li>Sistema de traducción interna segura de la administración del cantón de Tesino.</li>
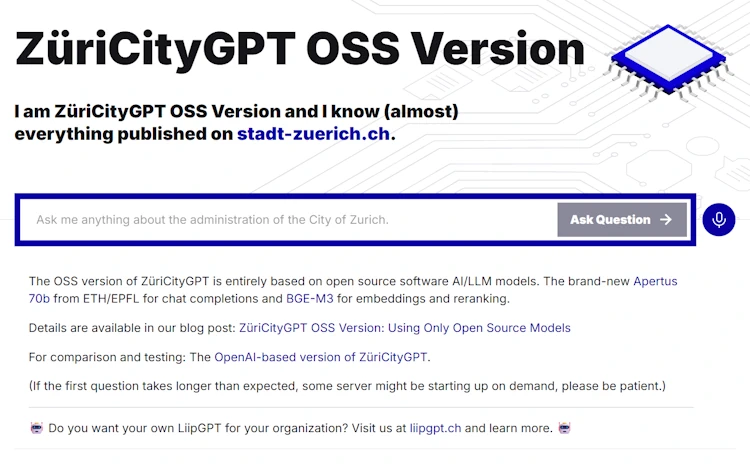
    <li>Asistente IA de la administración de la ciudad de Zúrich: <a href="https://oss.zuericitygpt.ch/" target="_blank" rel="noopener noreferrer">ZüriCityGPT</a>.</li>
    <li>La aplicación de traducción <a href="https://helvetra.ch/" target="_blank" rel="noopener noreferrer">Helvetra</a>. Con soporte para los seis dialectos del alemán de Suiza.</li>
    <li><a href="https://www.infomaniak.com/es/euria" target="_blank" rel="noopener noreferrer">Euria</a>, un asistente de IA para la nube europea de Infomaniak.</li>
    <li>Meditron, un LLM especializado en el sector médico y la salud.</li>
</ul>

<p><img src="/img/open-llm-basque-day-zuri-city-gpt.webp" loading="lazy" alt="Pantalla de ZüriCityGPT OSS Version con un campo para preguntar sobre la administración de la ciudad de Zúrich" width="750" height="464" /></p>

<h2>Ponencia - Ingeteam y Open LLM: cómo decidir entre modelos abiertos, cloud, local y Edge</h2>

<p><a href="https://www.linkedin.com/in/gaizkalanda/" target="_blank" rel="noopener noreferrer">Gaizka Landa</a>. Artificial Intelligence Manager - Ingeteam Research Institute.</p>

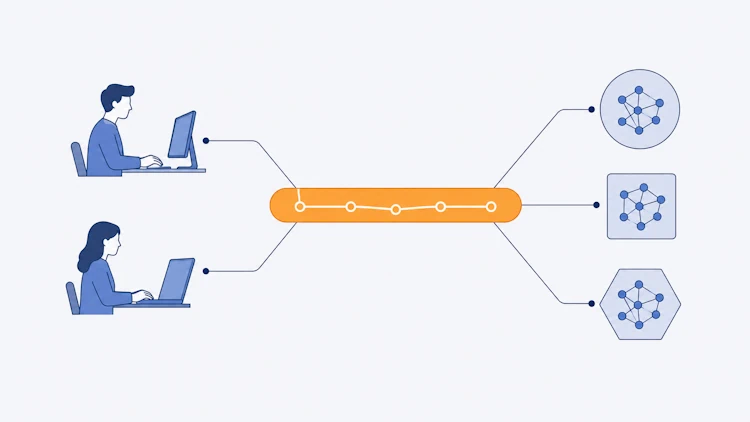
<p>Muy interesante la visión de una empresa muy pegada a la realidad del día a día. Han desarrollado una arquitectura híbrida que combina modelos abiertos y cerrados. El objetivo: <strong>no quedar atados a ningún proveedor</strong>.</p>

<p><img src="/img/open-llm-basque-day-sin-ataduras.webp" loading="lazy" alt="Ilustración de dos personas conectadas a una pasarela central que distribuye el acceso a varios modelos de IA" width="750" height="422" /></p>

<p>La mayor parte del uso de IA la canalizan vía API y han desarrollado un interfaz de usuario propio que facilita a los trabajadores el acceso a los diferentes modelos.</p>

<p>Nos resultó bastante sorprendente el dato del coste por usuario al mes: 2 €. Sí, "dos euros".</p>

<h2>Ponencia - Your Data, Your Models, Your Advantage: Open LLMs for European Industry</h2>

<p><a href="https://www.linkedin.com/in/floresherr/" target="_blank" rel="noopener noreferrer">Nicolas Flores-Herr</a>. Responsable de Modelos Funcionales y Sistemas de IA Generativa en Soofi y jefe de equipo en Fraunhofer IAIS.</p>

<p>Nicolas comenzó referenciando un relato de ficción titulado <a href="https://europe2031.ai/" target="_blank" rel="noopener noreferrer">Europe 2031</a>, que explora cómo la mala gestión de la inteligencia artificial podría llevar a Europa a la irrelevancia económica y política.</p>

<p>Habló de como escapar de "<strong>la trampa de los tokens</strong>". Recurriendo a modelos abiertos auditables, adaptables y soberanos. Como por ejemplo <strong>Soofi</strong> (Sovereign Open Source Foundation Models), que es un proyecto colaborativo alemán enfocado en desarrollar modelos fundacionales de inteligencia artificial soberanos para Europa orientados a un uso industrial y no como chatbots generales.</p>

<p><img src="/img/open-llm-basque-day-soberania-tecnologica.webp" loading="lazy" alt="Ilustración de una profesional sosteniendo servidores junto a iconos de seguridad, datos e infraestructura" width="750" height="422" /></p>

<p>Nicolas coincidió con Eneko en que hay una <strong>oportunidad de negocio en el <em>fine-tuning</em></strong> para soluciones de nicho y empresas.</p>

<h2>Ponencia - IA soberana en empresas y AAPP</h2>

<p><a href="https://www.linkedin.com/in/andres-pedre%C3%B1o-lloret/" target="_blank" rel="noopener noreferrer">Andrés Pedreño Lloret</a>, Head of Sales Public Sector at 1MillionBot.</p>

<p>Habló de "<strong>la trampa del modelo más potente</strong>". Una idea que también expusieron casi la totalidad del resto de ponentes. Para muchos casos no nos hace falta el modelo más potente, el mejor modelo de frontera. También hay muchas veces en los que en un proyecto de IA lo que falla no es el modelo, son otras cuestiones.</p>

<p>Uno de los productos de 1MillionBot son los asistentes conversacionales basados en inteligencia artificial. Interesante el planteamiento combinado de <strong>IA predictiva</strong> "clásica" para las respuestas deterministas y de <strong>IA generativa</strong> (LLMs avanzados) para conversaciones naturales con comprensión profunda.</p>

<p>Tranquilizadora, para los que estamos desarrollando productos basados en IA, la experiencia de que <strong>todos los productos de IA tienen un porcentaje de errores</strong> y que <strong>los guardarraíles también fallan</strong> en algunas ocasiones.</p>

<p>Están haciendo pruebas con modelos creados en el marco del <a href="https://alia.gob.es/" target="_blank" rel="noopener noreferrer">proyecto ALIA</a>. Una iniciativa pública del gobierno español para fomentar el impulso del castellano y lenguas cooficiales —catalán y valenciano, euskera y gallego— en el desarrollo y despliegue de la IA en el mundo.</p>

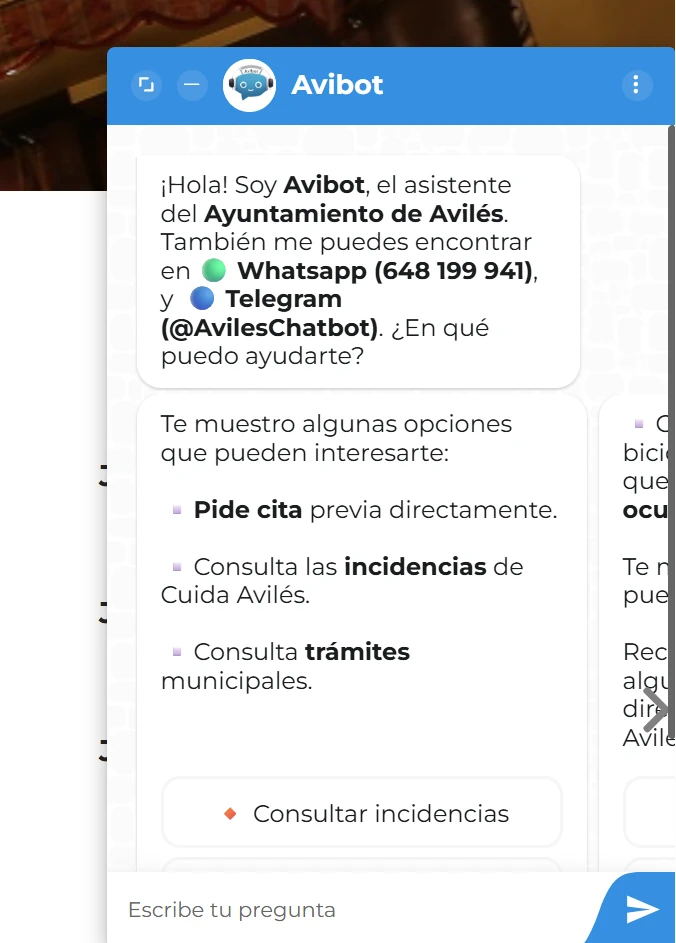
<p>Ejemplo de uno de los asistentes de 1MillionBot instalado en la web del <a href="https://aviles.es/" target="_blank" rel="noopener noreferrer">Ayuntamiento de Aviles</a>:</p>

<p><img src="/img/open-llm-basque-day-aviles.webp" loading="lazy" alt="Ventana de Avibot, asistente del Ayuntamiento de Avilés, mostrando opciones para pedir cita previa, consultar incidencias y trámites municipales" width="450" height="627" /></p>

<h2>Mesa redonda - Modelos abiertos: coste, soberanía y decisiones reales</h2>

<p>La jornada terminó con una mesa redonda de debate moderada por <a href="https://www.linkedin.com/in/iraitz-cordero/" target="_blank" rel="noopener noreferrer">Iraitz Cordero</a> de Mondragon Unibertsitatea en la que participaron:</p>

<ul>
    <li><a href="https://www.linkedin.com/in/itziar-cort%C3%A9s/" target="_blank" rel="noopener noreferrer">Itziar Cortes</a> de Elhuyar</li>
    <li><a href="https://www.linkedin.com/in/gunamuno/" target="_blank" rel="noopener noreferrer">Gorka Unamuno</a> de Multiverse Computing</li>
    <li><a href="https://www.linkedin.com/in/carlos-tom%C3%A1s-moro/" target="_blank" rel="noopener noreferrer">Carlos Tomás</a> de Innkia</li>
    <li><a href="https://www.linkedin.com/in/endika-gil-uriarte/" target="_blank" rel="noopener noreferrer">Endika Gil Uriarte</a> de Alias Robotics</li>
</ul>

<p>El debate resultó interesante y se habló de distintos temas. Me quedo con la idea compartida por los intervinientes de que en Euskadi tenemos que <strong>formar talento</strong> y <strong>atraer talento</strong> en el ámbito de la IA. Alguien dijo, lo apunte en mis notas, "necesitamos gente que sepa hacer estas cosas". Reflexión que sirve de pie para mencionar a dos de los compañeros de Adimedia que me acompañaron al evento: <a href="https://www.linkedin.com/in/oihane-zaldua/" target="_blank" rel="noopener noreferrer">Oihane Zaldua</a> y <a href="https://www.linkedin.com/in/sergio-hern%C3%A1ndez-castro/" target="_blank" rel="noopener noreferrer">Sergio Hernández</a>. Forman parte de ese grupo de profesionales vascos que "saben hacer estas cosas".</p>

<p><img src="/img/open-llm-basque-day-futuro-ia.webp" loading="lazy" alt="Ilustración de dos profesionales trabajando frente a ordenadores con una estructura de IA compartida entre ambos" width="750" height="422" /></p>]]></content><author><name>Aunitz Giménez</name></author><category term="inteligencia artificial" /><category term="memorandos" /><summary type="html"><![CDATA[Notas y reflexiones sobre la primera edición del Open LLM Basque Day celebrado en Bilbao el 18 de junio de 2026.]]></summary></entry><entry><title type="html">Dark patterns en el comercio online</title><link href="https://www.aunitz.net/dark-patterns-en-comercio-online/" rel="alternate" type="text/html" title="Dark patterns en el comercio online" /><published>2026-06-21T10:00:00+02:00</published><updated>2026-06-21T10:00:00+02:00</updated><id>https://www.aunitz.net/dark-patterns-en-comercio-online</id><content type="html" xml:base="https://www.aunitz.net/dark-patterns-en-comercio-online/"><![CDATA[<p>Hace muchos años que soy socio del Club Eroski y lector habitual de su <a href="https://www.consumer.es/" target="_blank" rel="noopener noreferrer">revista mensual Consumer</a>. Se publica en papel y en versión digital (acceso gratuito). Cubre temas de consumo cotidiano, defensa del consumidor, comparativas de productos, etc. En noviembre de 2025 publicaron un artículo sobre cómo muchas <a href="https://www.consumer.es/economia-domestica/patrones-oscuros-internet-asi-manipulan-plataformas-para-comprar-sin-parar" target="_blank" rel="noopener noreferrer">plataformas online de venta aplican patrones oscuros o dark patterns</a> para influir en nuestro comportamiento e inducir la compra. En no pocas ocasiones, de productos que no necesitamos.</p>

<p>Explica el artículo que de acuerdo con un <a href="https://op.europa.eu/en/publication-detail/-/publication/606365bc-d58b-11ec-a95f-01aa75ed71a1/language-en" target="_blank" rel="noopener noreferrer">informe publicado por la Comisión Europea</a>, <strong>el 97 % de las webs y aplicaciones más utilizadas </strong>por los consumidores de la Unión Europea incorporan al menos un patrón oscuro, y por lo general más de uno.</p>

<p><img src="/img/dark-patterns-en-comercio-online-01.webp" loading="lazy" alt="Ilustración de un usuario siendo dirigido a pulsar un botón naranja destacado en la pantalla de un ordenador" width="750" height="422" /></p>

<p>El término <strong>"dark pattern"</strong> fue acuñado en 2010 por el diseñador UX británico Harry Brignull, cuando lanzó el sitio web <em>darkpatterns.org</em> (actualmente renombrado como <a href="https://www.deceptive.design/" target="_blank" rel="noopener noreferrer"><em>Deceptive Design</em></a>). Su objetivo era identificar y denunciar patrones de interfaz diseñados para <strong>manipular a las personas usuarias</strong> y llevarlas a realizar acciones que no habrían elegido libremente.</p>

<p>La definición original de Brignull era:</p>

<blockquote><p>"Trucos utilizados en sitios web y aplicaciones que hacen que hagas cosas que no pretendías hacer."</p></blockquote>

<p>Antes de 2010 estas prácticas ya existían, pero no tenían un nombre común. El mérito de Brignull fue ponerles nombre: con una etiqueta reconocible, la comunidad UX, los investigadores y, con el tiempo, los reguladores pudieron analizarlas, clasificarlas y combatirlas.</p>

<p>El objetivo del artículo de Consumer —y el de este post— es ese: que conozcamos los patrones más habituales para poder detectarlos cuando los encontremos.</p>

<p>Funcionan porque no actúan al azar: cada uno de estos patrones <a href="/uso-sesgos-cognitivos-marketing/">explota un sesgo cognitivo concreto</a> que afecta a nuestra forma de decidir.</p>

<h2>Patrones oscuros más frecuentes en webs y apps</h2>

<p>Estos son los doce patrones más comunes. Para cada uno incluyo un ejemplo real de cosecha propia o extraído de <a href="https://hallofshame.design/" target="_blank" rel="noopener noreferrer">Hall of Shame</a>, un repositorio que identifica y documenta casos de diseño engañoso en webs y aplicaciones de empresas conocidas. Conocerlos no nos vuelve inmunes —la información no desactiva los sesgos cognitivos—, pero sí nos hace algo menos vulnerables a la manipulación.</p>

<h3>1. Falsa jerarquía <em>(False hierarchy)</em></h3>

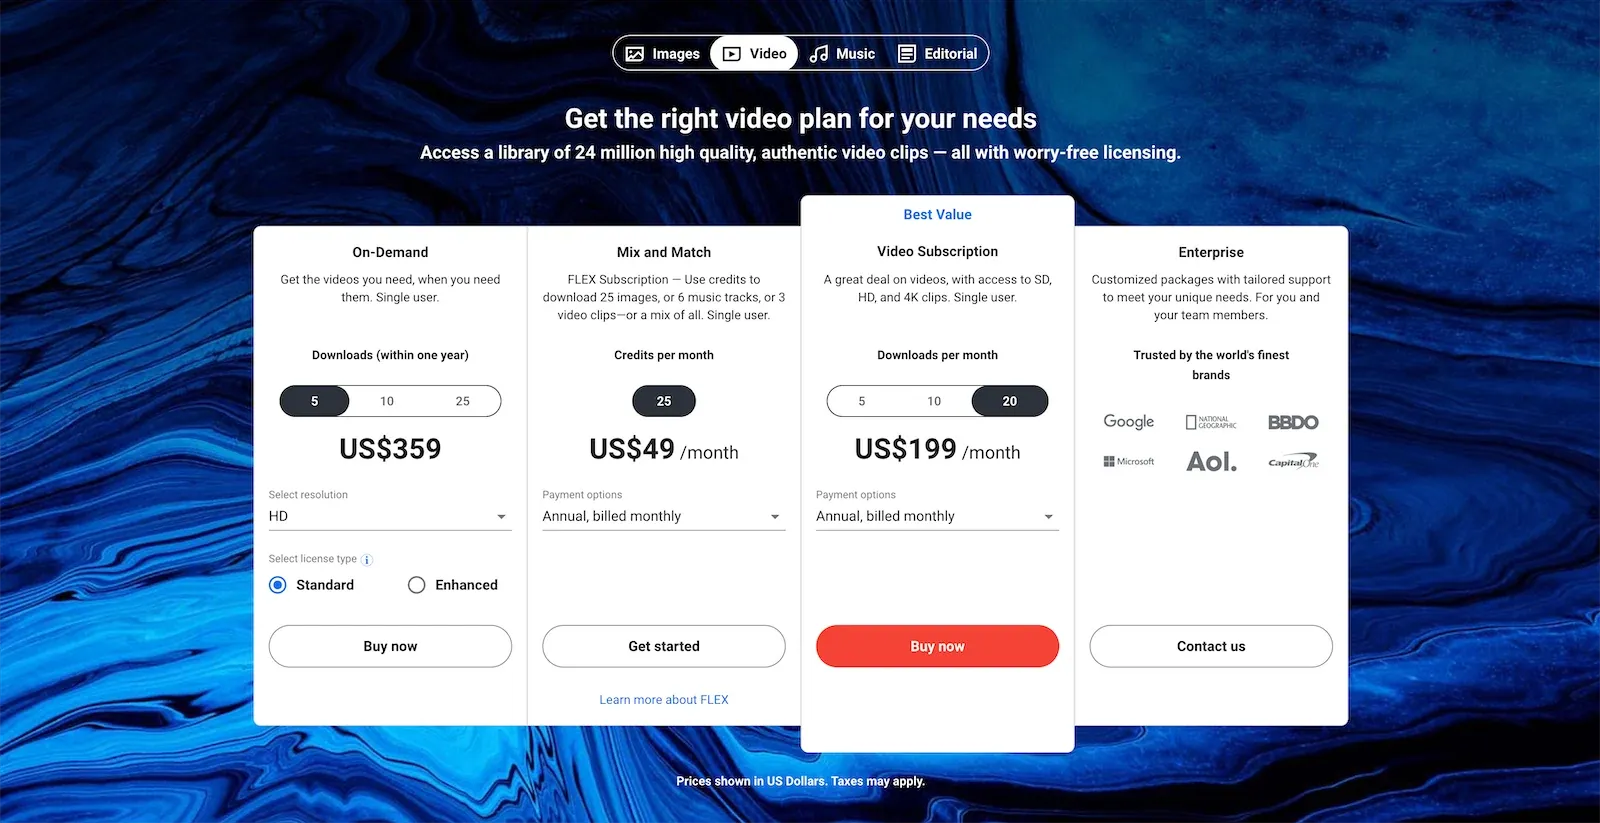
<p>Cuando la web despliega varias opciones, no las presenta con la misma importancia visual. Una de ellas —la que le interesa a la plataforma— aparece destacada con un botón más grande, un color más llamativo o una posición más prominente. El objetivo es que la selecciones sin pararte a pensar.</p>

<p>Hay mil ejemplos de este tipo de patrón. La captura es de Shutterstock.</p>

<p><a href="/img/dark-patterns-01-falsa-jerarquia-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-01-falsa-jerarquia-xl.webp" loading="lazy" alt="Página de precios de Shutterstock con cuatro planes, donde el plan «Video Subscription» aparece visualmente destacado con etiqueta «Best Value» y botón rojo «Buy now», frente a los botones más discretos del resto de planes" width="750" height="386" /></a></p>

<h3>2. Insistencia <em>(Nagging)</em></h3>

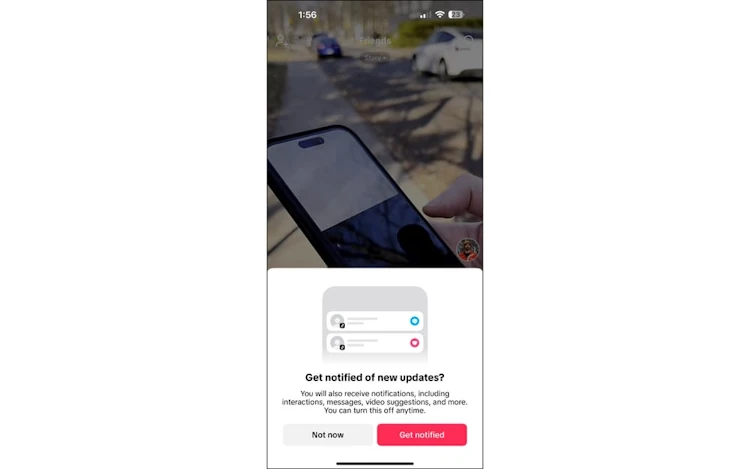
<p>La plataforma te bombardea con notificaciones, ventanas emergentes y avisos repetitivos para que realices una acción concreta: activar las notificaciones, suscribirte, contratar la versión de pago… Si los ignoras, vuelven a aparecer. Una y otra vez.</p>

<p>A pesar de rechazar repetidamente el acceso a notificaciones y a la lista de contactos, TikTok sigue solicitando esos permisos en cada sesión, con botones primarios destacados y texto que insinúa que te pierdes funciones clave.</p>

<p><img src="/img/dark-patterns-02-insistencia.webp" loading="lazy" alt="Pop-up de TikTok en móvil solicitando permiso para enviar notificaciones, con el botón «Get notified» en rojo prominente y el botón «Not now» en gris discreto" width="750" height="469" /></p>

<h3>3. Trampa sin salida <em>(Roach motel)</em></h3>

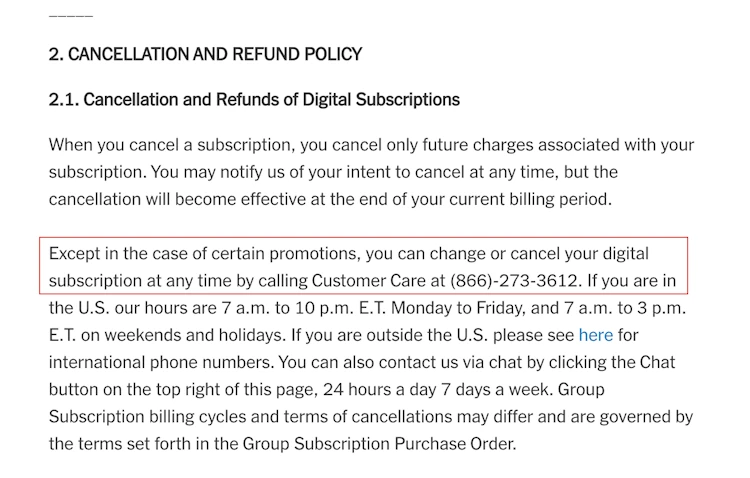
<p>Contratar es sencillo: unos pocos clics y ya eres suscriptor. Darte de baja es otra historia. El botón de cancelación no existe, está enterrado en los ajustes más recónditos o directamente hay que llamar por teléfono a un servicio de atención al cliente diseñado para desgastarte.</p>

<p>Suscribirse a The New York Times se hace en segundos online. Cancelar obliga a llamar por teléfono a un servicio de atención al cliente, diseñado expresamente para desgastar y retener al abonado.</p>

<p><img src="/img/dark-patterns-03-trampa-sin-salida.webp" loading="lazy" alt="Política de cancelación de The New York Times donde se indica que para cancelar la suscripción digital hay que llamar por teléfono al servicio de atención al cliente" width="750" height="478" /></p>

<h3>4. Acciones forzadas <em>(Forced actions)</em></h3>

<p>La web te obliga a realizar una acción que no pedías para poder continuar. El ejemplo más habitual: registrarte para ver el precio final de una compra. O encontrarte con que la casilla de suscripción a la newsletter ya viene marcada por defecto en el formulario.</p>

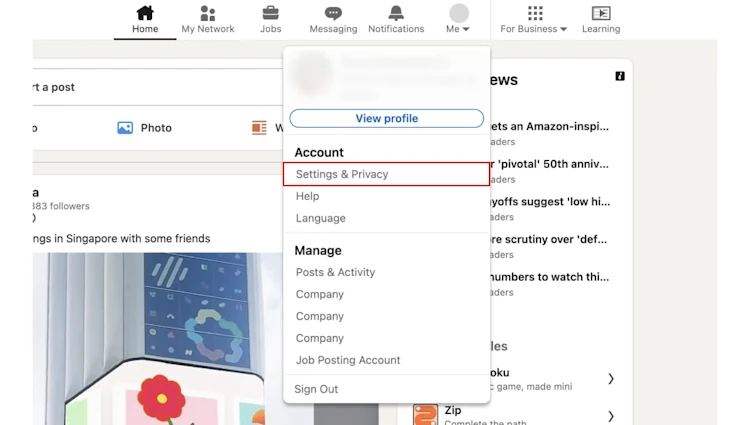
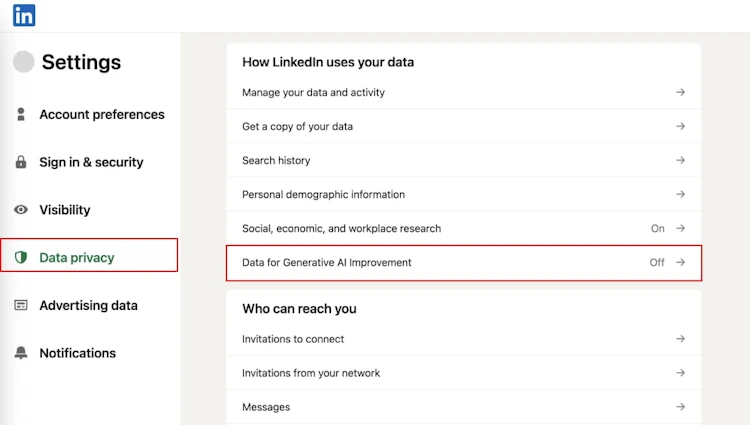
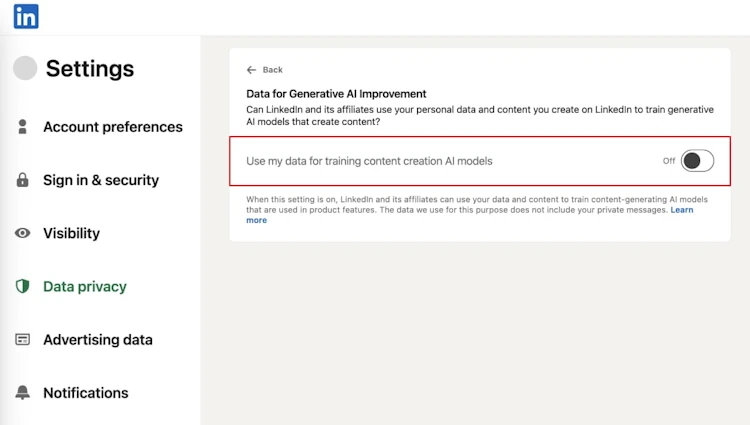
<p>LinkedIn activó por defecto la opción «Use my data for training content creation AI models». Para desactivarla, el usuario debe navegar por tres submenús de configuración.</p>

<p><img src="/img/dark-patterns-04-acciones-forzadas-01.webp" loading="lazy" alt="Menú de perfil de LinkedIn con la opción «Settings &amp; Privacy» resaltada, primer paso de la ruta de tres submenús para acceder a la configuración de privacidad de datos" width="750" height="425" /></p>

<p><img src="/img/dark-patterns-04-acciones-forzadas-02.webp" loading="lazy" alt="Configuración de privacidad de LinkedIn mostrando la sección «Data privacy» con la opción «Data for Generative AI Improvement» resaltada" width="750" height="425" /></p>

<p><img src="/img/dark-patterns-04-acciones-forzadas-03.webp" loading="lazy" alt="Configuración de LinkedIn mostrando la opción «Use my data for training content creation AI models» desactivada, oculta tras tres niveles de navegación" width="750" height="425" /></p>

<h3>5. Información oculta <em>(Hidden information)</em></h3>

<p>Los datos importantes —el coste del envío, las comisiones, las condiciones de una renovación automática— no aparecen hasta el último paso del proceso. O aparecen, pero en letra pequeña y en un lugar donde nadie mira.</p>

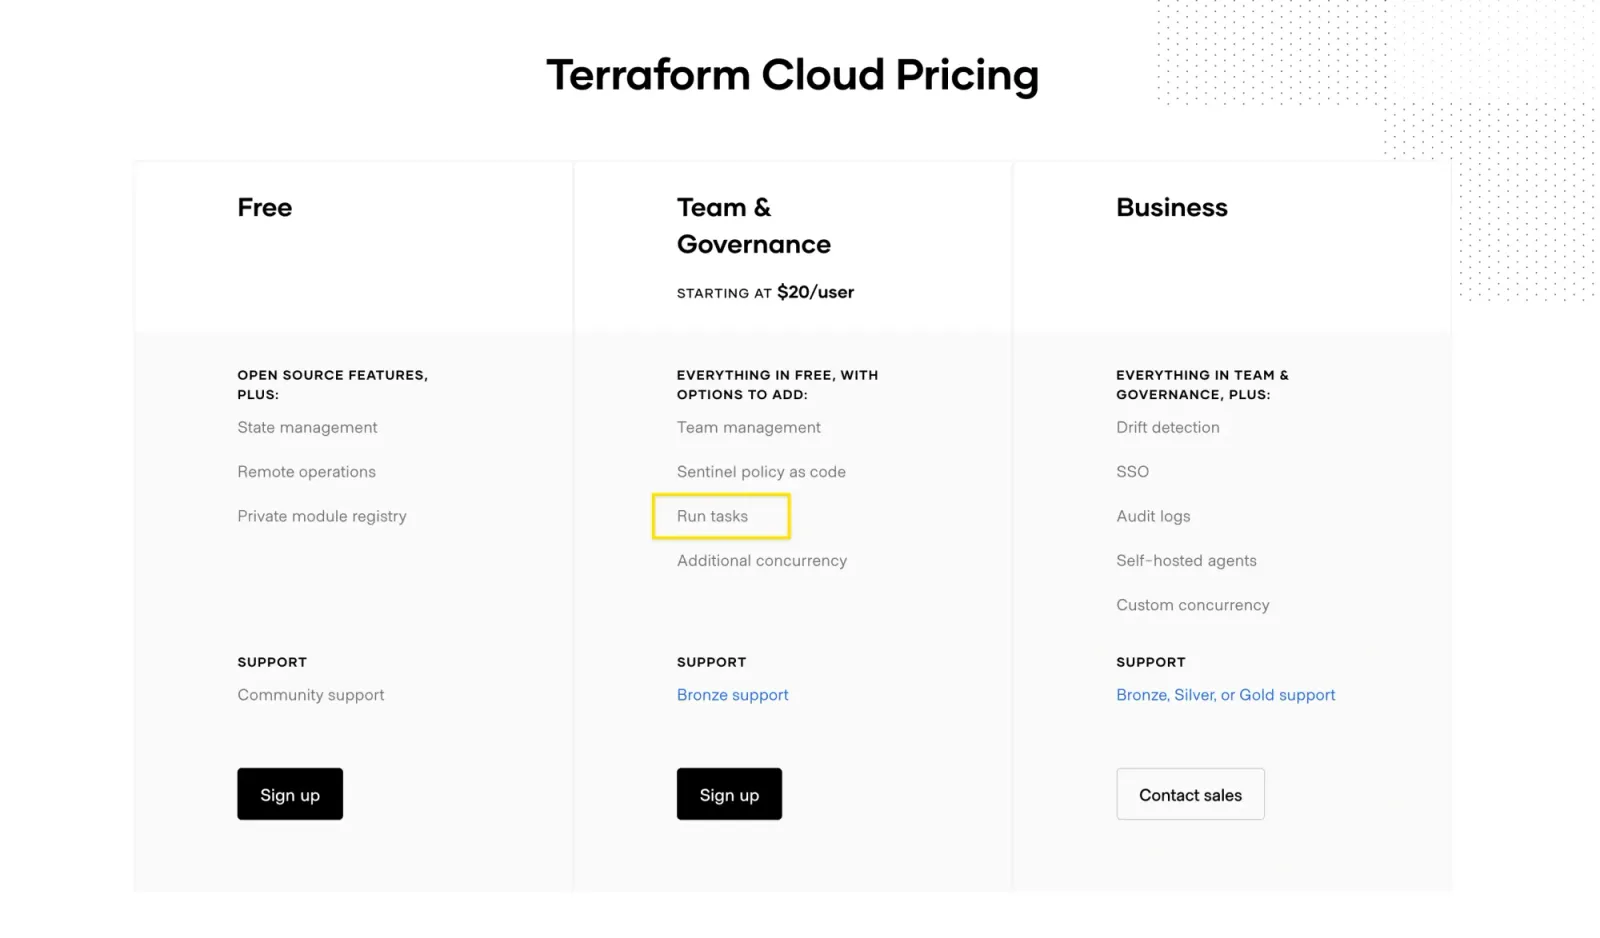
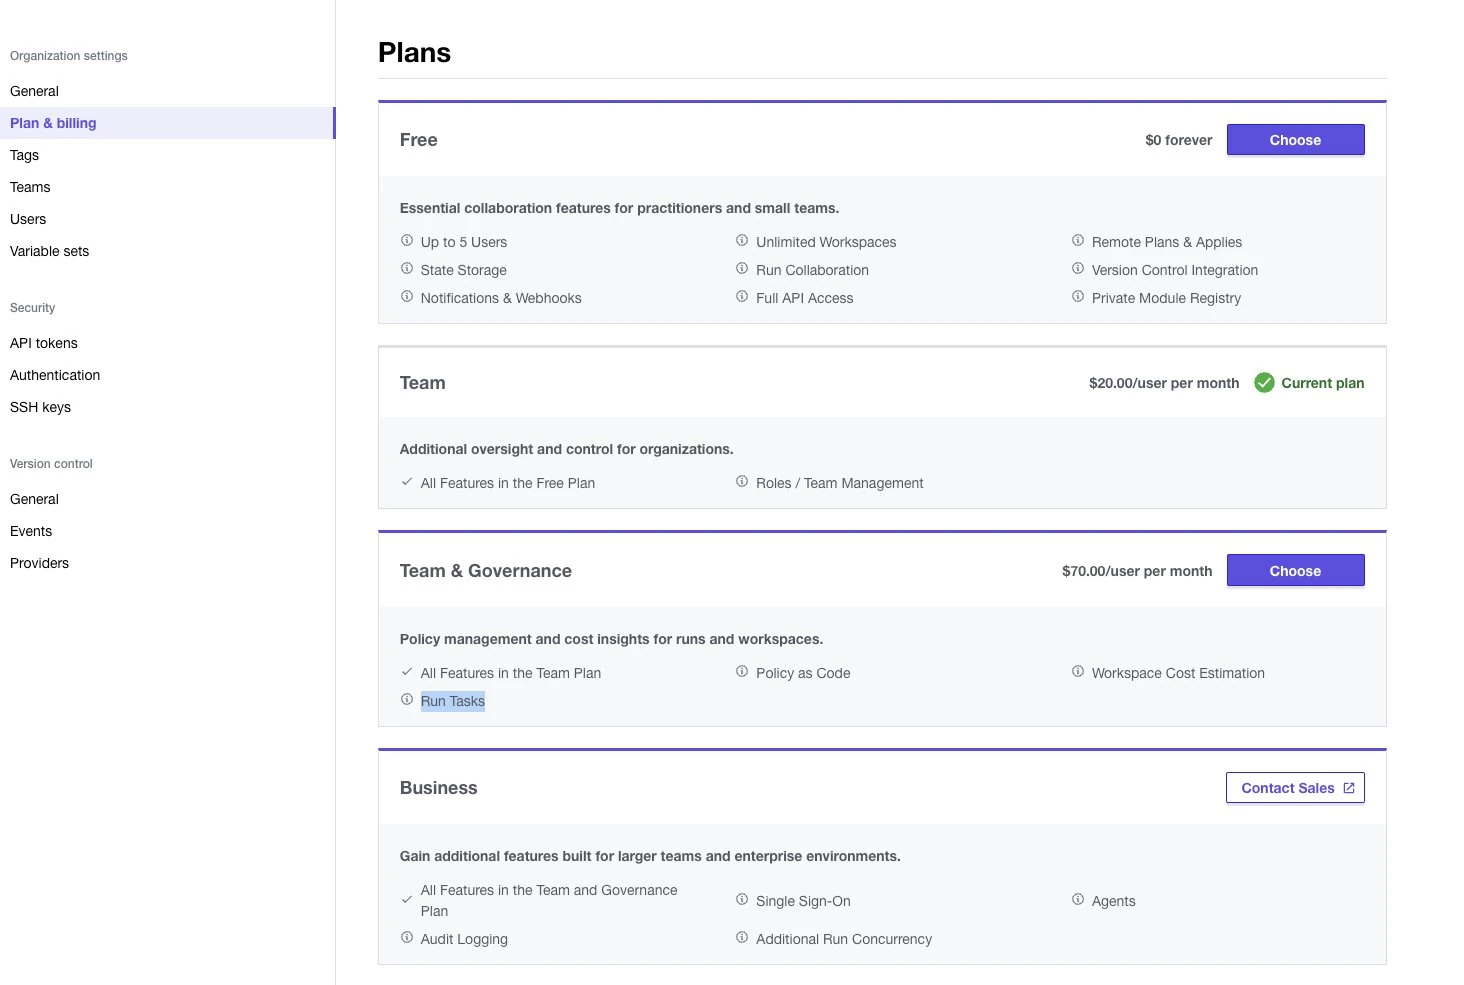
<p>HashiCorp anuncia una funcionalidad «incluida» en la tarifa de 20 $/usuario. Solo tras contratar se descubre que «starting at» escondía un cargo adicional obligatorio para activar esa misma función.</p>

<p><a href="/img/dark-patterns-05-informacion-oculta-01-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-05-informacion-oculta-01-xl.webp" loading="lazy" alt="Página de precios de Terraform Cloud con tres planes; la funcionalidad «Run tasks» aparece listada en el plan «Team &amp; Governance» (desde 20 $/usuario) sin aclarar que requiere un cargo adicional" width="750" height="440" /></a></p>

<p><a href="/img/dark-patterns-05-informacion-oculta-02-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-05-informacion-oculta-02-xl.webp" loading="lazy" alt="Panel de administración de Terraform Cloud mostrando que «Run Tasks» es en realidad un complemento de pago adicional dentro del plan Team &amp; Governance, no incluido en el precio base" width="750" height="504" /></a></p>

<h3><em>6. Scroll infinito (Infinite scroll)</em></h3>

<p>El contenido no tiene fin: siempre hay algo más justo debajo de lo que acabas de ver. No hay páginas, no hay paginación, no hay ninguna señal que indique cuánto tiempo llevas desplazándote. La plataforma combina este patrón con algoritmos de recomendación para garantizar que lo que aparece a continuación sea exactamente lo que más probabilidades tiene de mantenerte enganchado.</p>

<p>Amazon colecciona un buen número de patrones oscuros. Entre ellos el del <em>scroll</em> infinito.</p>

<p><video src="/img/dark-patterns-06-scroll-infinito.webm" controls="" loop="" muted="" playsinline="" title="Ejemplo de scroll infinito en una página que carga contenido continuamente al bajar"></video></p>

<h3>7. Dotación <em>(Endowment)</em></h3>

<p>Cuanto más tiempo llevas en la plataforma, más has acumulado: puntos, seguidores, trofeos, niveles, racha de días consecutivos… Todo ese historial crea un vínculo difícil de romper. Si te vas, pierdes lo que has construido. Y eso duele, aunque lo acumulado no tenga ningún valor real fuera de la propia plataforma.</p>

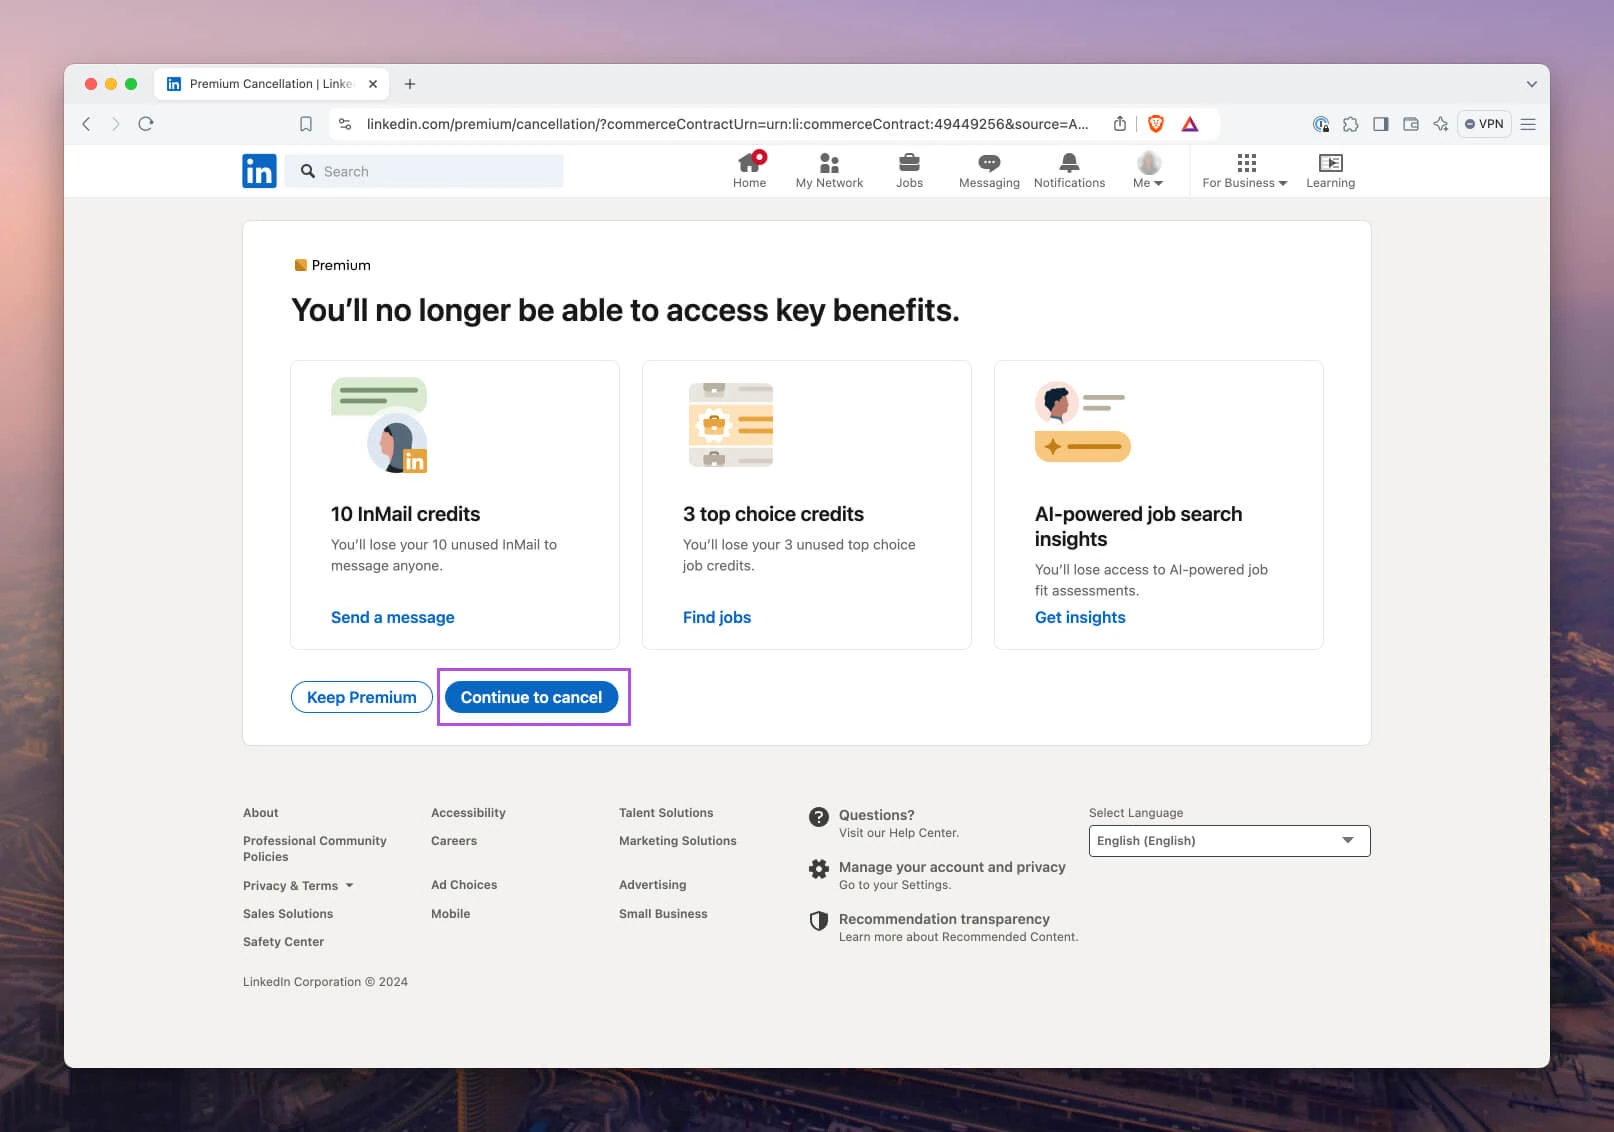
<p>Durante la baja de LinkedIn Premium, una pantalla enumera lo que el usuario perderá: «10 créditos InMail», «3 créditos Top Choice Jobs» e «insights de IA». No es información neutra: es una lista de «pertenencias» acumuladas diseñada para activar la aversión a la pérdida.</p>

<p><a href="/img/dark-patterns-07-dotacion-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-07-dotacion-xl.webp" loading="lazy" alt="Pantalla de cancelación de LinkedIn Premium enumerando los beneficios que se perderán: 10 créditos InMail, 3 créditos Top Choice Jobs e insights de IA, junto a botones «Keep Premium» y «Continue to cancel»" width="750" height="526" /></a></p>

<h3><em>8. Tareas de desgaste (Grinding)</em></h3>

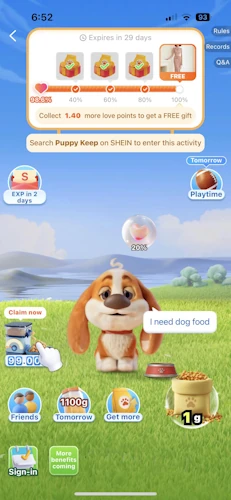
<p>La plataforma te pide que realices tareas sencillas o repetitivas —ver un vídeo completo, rellenar un formulario, completar un reto diario— a cambio de puntos, créditos o acceso a contenido. El objetivo real no es que hagas esas tareas, sino que mientras las haces estés expuesto a publicidad o consumiendo lo que la plataforma quiere que consumas.</p>

<p>Este patrón es muy utilizado por los juegos gratuitos para que te pases a opciones de pago para evitar las tareas de desgaste. También por plataformas de microcompras como Shein.</p>

<p><img src="/img/dark-patterns-08-tareas-de-desgaste.webp" loading="lazy" alt="Juego de mascota virtual en la app de Shein con barra de progreso para conseguir un regalo gratis, diseñado para mantener al usuario interactuando con la plataforma" width="231" height="500" /></p>

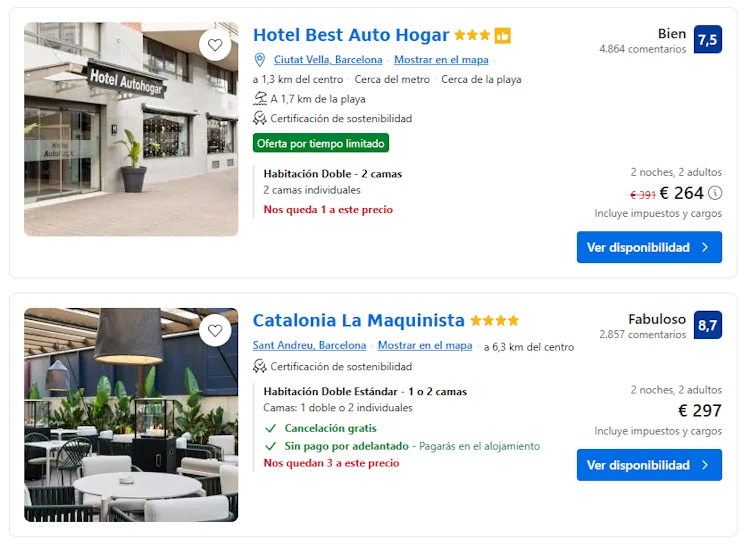
<h3>9. Escasez <em>(Scarcity)</em></h3>

<p>«Quedan solo 3 unidades». «Otras 12 personas están mirando esto ahora mismo». La sensación de disponibilidad limitada nos empuja a tomar decisiones rápidas, por miedo a quedarnos sin algo. El problema es que esa escasez es, con frecuencia, fabricada.</p>

<p>Booking es uno de los ejemplos estrella en el uso (abuso) de este a patrón.</p>

<p><img src="/img/dark-patterns-09-escasez.webp" loading="lazy" alt="Listado de hoteles en Booking.com con mensajes de escasez en rojo («Nos queda 1 a este precio», «Nos quedan 3 a este precio») junto a etiquetas de «Oferta por tiempo limitado»" width="750" height="547" /></p>

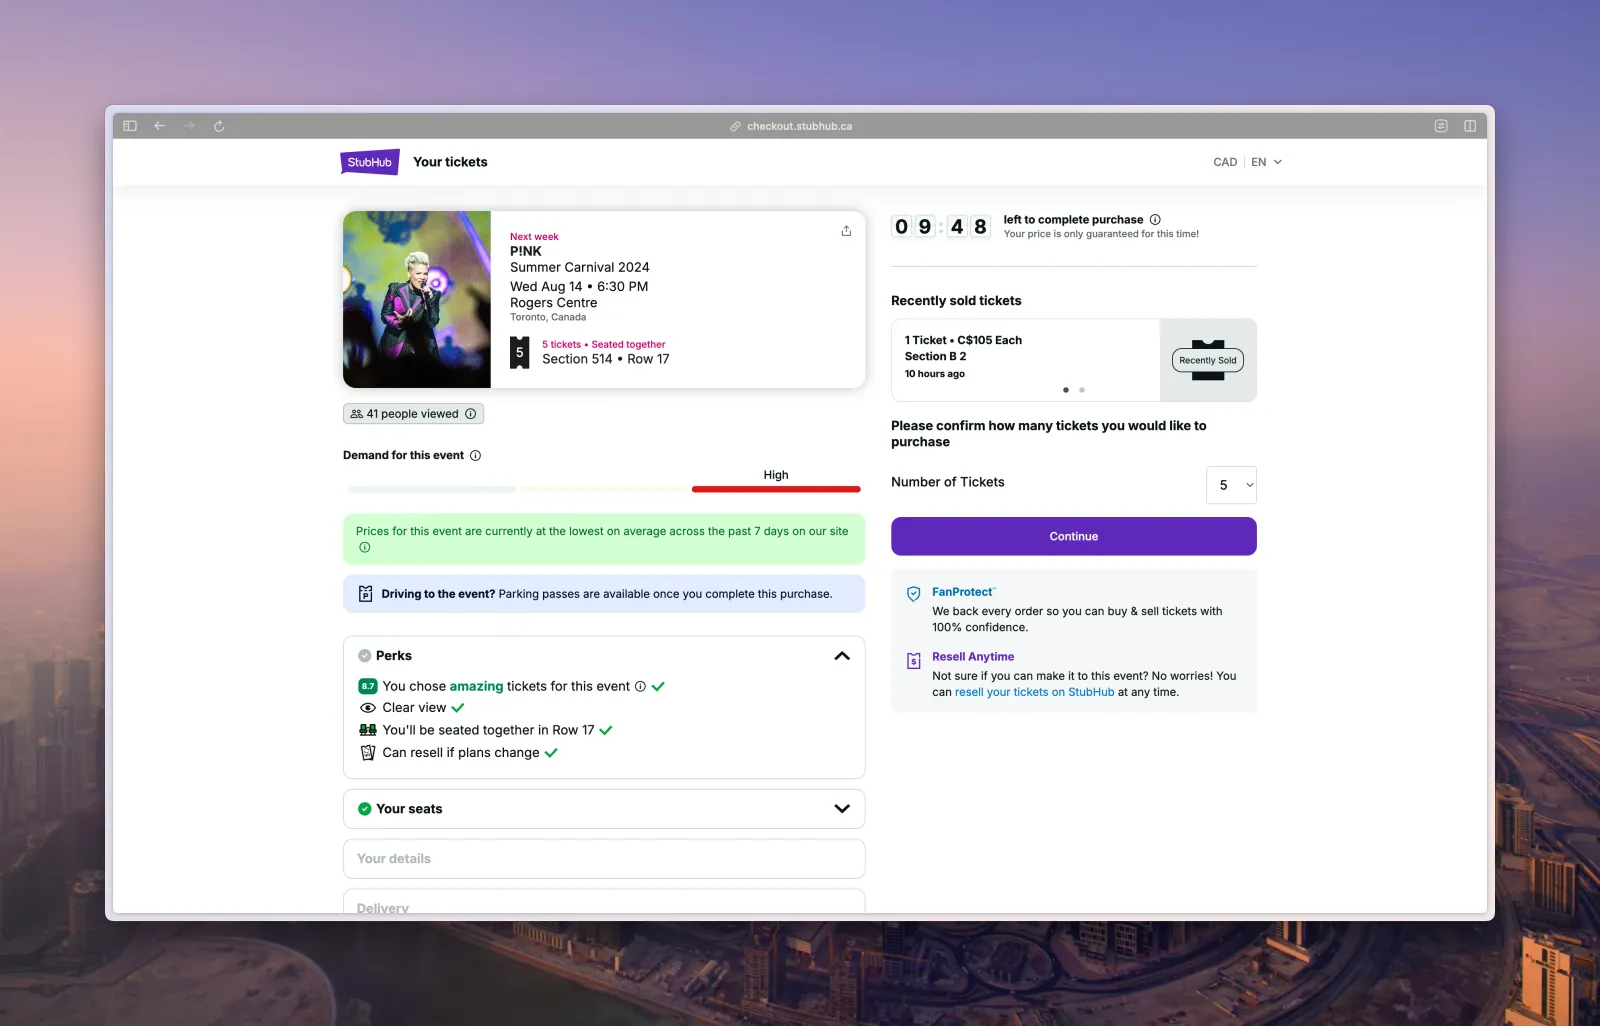
<h3>10. Urgencia <em>(False urgency)</em></h3>

<p>La cuenta atrás lleva horas corriendo. La oferta termina en 00:07:32. Pero si recargas la página, el contador vuelve a empezar. La urgencia artificial activa nuestra aversión a la pérdida y nos lleva a comprar sin reflexionar.</p>

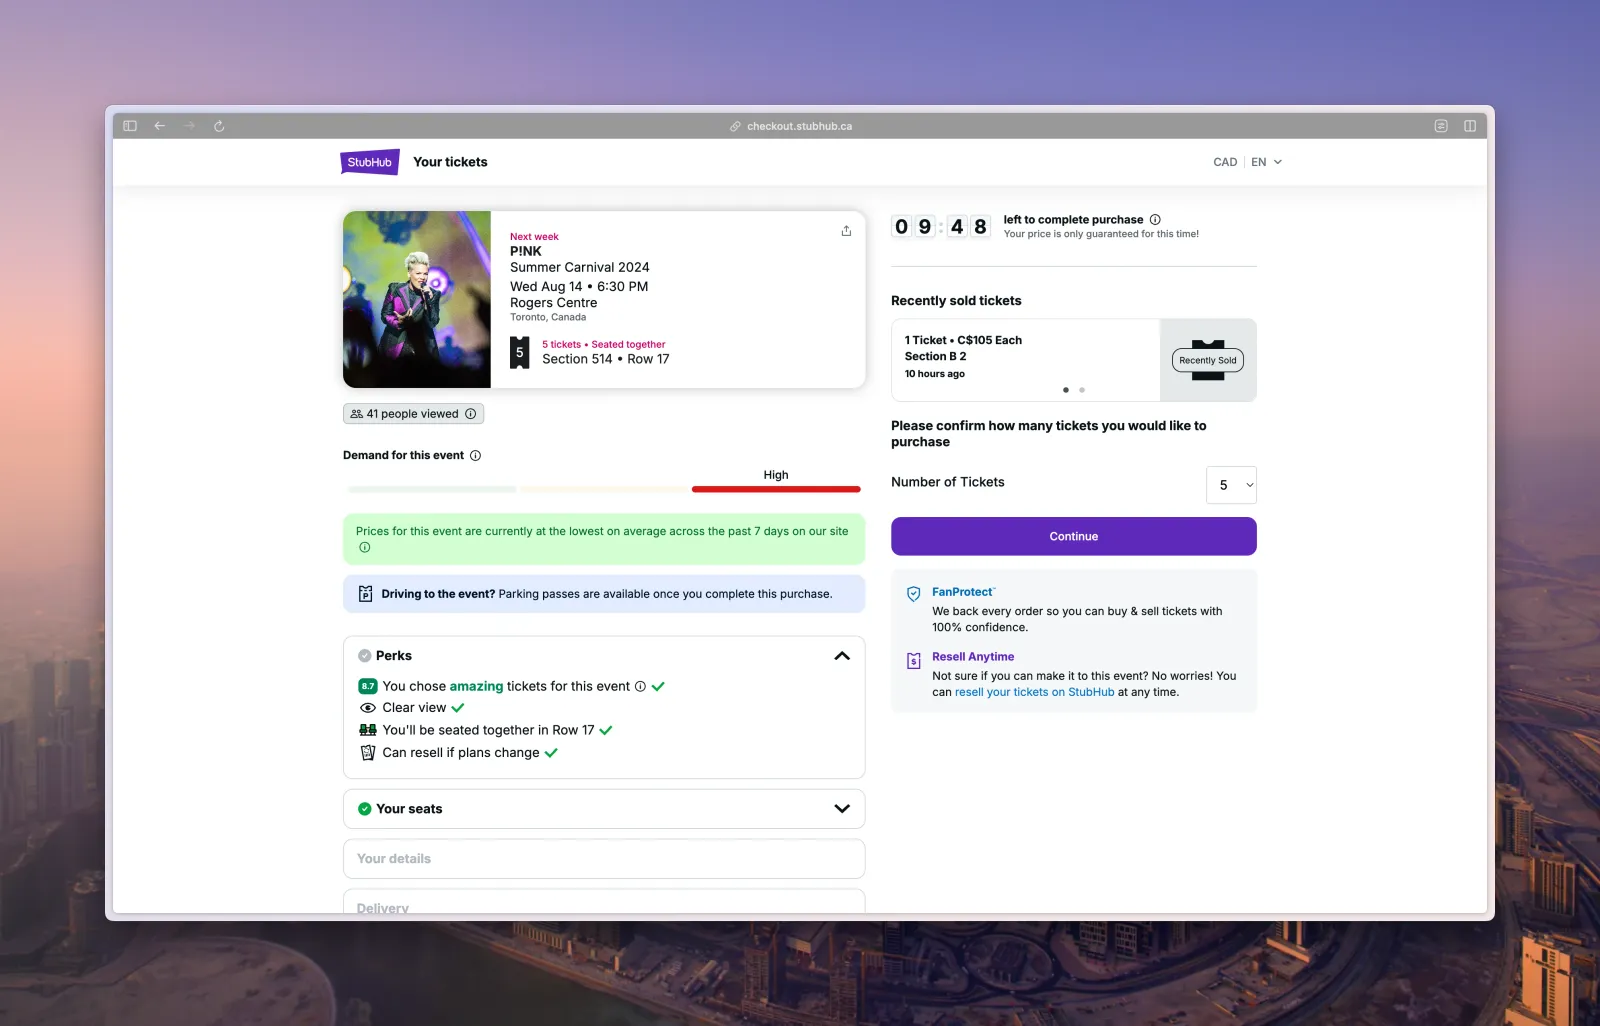
<p>En StubHub aparece un temporizador de 10 minutos en la esquina superior derecha de la pantalla. El objetivo es impedir que el usuario compare precios en otras plataformas antes de completar la compra.</p>

<p><a href="/img/dark-patterns-10-urgencia-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-10-urgencia-xl.webp" loading="lazy" alt="Proceso de compra de entradas en StubHub con temporizador de cuenta atrás de 10 minutos en la esquina superior derecha de la pantalla" width="750" height="481" /></a></p>

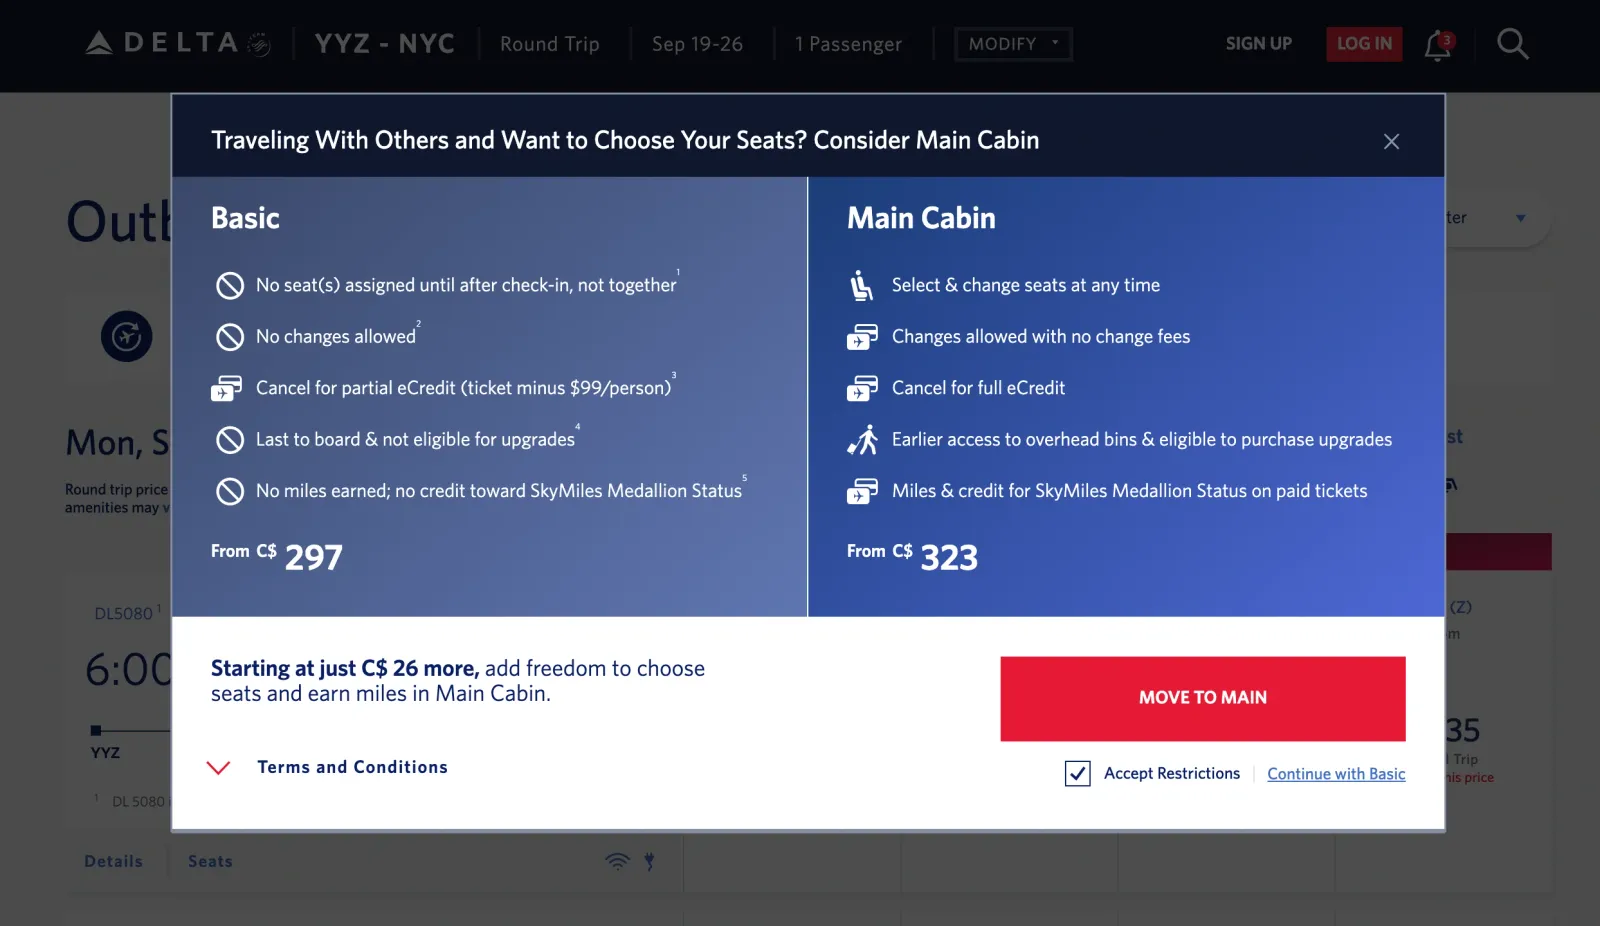
<h3>11. Atención dirigida <em>(Misdirection)</em></h3>

<p>A través de colores, tamaños, animaciones o posicionamiento, la interfaz dirige tu atención hacia un elemento concreto y la aparta de otro que prefieren que no veas. Un ejemplo habitual: el botón de «aceptar todo» en verde y bien visible; el de «gestionar preferencias» en gris y casi ilegible.</p>

<p>Delta Airlines utiliza este patrón para forzar a las personas usuarias a contratar una opción más cara en lugar del paquete básico.</p>

<p><a href="/img/dark-patterns-11-atencion-dirigida-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-11-atencion-dirigida-xl.webp" loading="lazy" alt="Modal de Delta Airlines comparando las tarifas Basic y Main Cabin, con el botón «MOVE TO MAIN» en rojo muy destacado y la opción «Continue with Basic» como texto apenas visible" width="750" height="434" /></a></p>

<h3>12. Sobrecarga informativa <em>(Information overload)</em></h3>

<p><a href="/paralisis-por-analisis/">Demasiada información, demasiadas opciones y demasiados estímulos a la vez</a>. La persona usuaria se satura, pierde la capacidad de evaluar con calma y acaba tomando la decisión de menor resistencia: la que la plataforma ha preparado para ese momento de agotamiento cognitivo.</p>

<p>En StubHub, una sola pantalla acumula 5 mensajes de urgencia y escasez simultáneos (demanda alta, último precio mínimo, 41 vistas recientes, última venta, temporizador). La saturación informativa impide la evaluación tranquila y empuja a la compra impulsiva.</p>

<p><a href="/img/dark-patterns-12-sobrecarga-informativa-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/dark-patterns-12-sobrecarga-informativa-xl.webp" loading="lazy" alt="Pantalla de compra en StubHub acumulando cinco mensajes de urgencia y escasez simultáneos: demanda alta, precio mínimo en los últimos 7 días, 41 vistas recientes, última venta y temporizador de cuenta atrás" width="750" height="481" /></a></p>

<h2>Contar hasta diez antes de hacer clic</h2>

<p>En el informe de la Comisión Europea apuntan que para evitar caer en estas trampas "la principal recomendación sería <strong>contar hasta diez antes de hacer clic o realizar cualquier compra</strong>, porque así es más fácil que se active el sistema racional y reflexivo del cerebro".</p>

<p><img src="/img/dark-patterns-en-comercio-online-02.webp" loading="lazy" alt="Ilustración de una usuaria levantando la mano en señal de rechazo ante un botón naranja destacado en la pantalla de un ordenador" width="750" height="422" /></p>]]></content><author><name>Aunitz Giménez</name></author><category term="sesgos cognitivos" /><category term="buenas prácticas de usabilidad" /><summary type="html"><![CDATA[Los 12 dark patterns más frecuentes en webs y apps: cómo funcionan, qué sesgos explotan y cómo detectarlos.]]></summary></entry><entry><title type="html">Inteligencia artificial: mira el cambio directamente a los ojos</title><link href="https://www.aunitz.net/inteligencia-artificial-mira-cambio-directamente-ojos/" rel="alternate" type="text/html" title="Inteligencia artificial: mira el cambio directamente a los ojos" /><published>2026-06-02T08:00:00+02:00</published><updated>2026-06-02T08:00:00+02:00</updated><id>https://www.aunitz.net/inteligencia-artificial-mira-cambio-directamente-ojos</id><content type="html" xml:base="https://www.aunitz.net/inteligencia-artificial-mira-cambio-directamente-ojos/"><![CDATA[<p><a href="https://aprendemosjuntos.bbva.com/" target="_blank" rel="noopener noreferrer">Aprendemos juntos</a> es una iniciativa de BBVA (Banco Bilbao Vizcaya Argentaria) en la que dan voz a algunas de las mentes más brillantes del mundo para que nos aporten historias útiles e inspiradoras. <em>Aprendemos juntos</em> ha sido reconocido por Naciones Unidas por su contribución a los Objetivos de Desarrollo Sostenible (ODS).</p>

<p>A finales de abril publicaron la charla completa con <a href="https://es.wikipedia.org/wiki/Jos%C3%A9_Ignacio_Latorre" target="_blank" rel="noopener noreferrer">José Ignacio Latorre</a>, físico teórico. Ha dedicado su vida a la investigación tanto en física cuántica como en mecánica cuántica e inteligencia artificial. Actualmente es el director del Centro de Tecnologías Cuánticas en Singapur. Un centro de 340 personas y 100 líneas de investigación donde están construyendo ordenadores cuánticos.</p>

<div class="embed-responsive embed-responsive-16by9">
    <iframe loading="lazy" width="720" height="405" title="Inteligencia artificial: cómo entenderla sin miedo | José Ignacio Latorre, físico cuántico" class="embed-responsive-item" src="https://www.youtube-nocookie.com/embed/mm4W5Y-TNH0?rel=0&amp;showinfo=0" frameborder="0" allowfullscreen=""></iframe>
</div>

<p>Al comienzo de su intervención, la cual te recomiendo que escuches entera con calma y atención plena, porque merece mucho la pena, explica una experiencia personal reveladora, ocurrida recientemente en su centro de investigación en Singapur. Un investigador postdoctoral le muestra una IA avanzada especializada en física matemática por la que paga 250 dólares al mes. La herramienta había sido capaz de resolver completamente su investigación científica y generar un artículo académico impecable: introducción, razonamiento, conclusiones y referencias, todo correcto y sin errores. Latorre decide probar personalmente la herramienta con un problema complejo en el que llevaba meses trabajando. Tras varias horas de razonamiento autónomo, la IA produce un análisis completo y concluye que la línea de investigación no funciona, ahorrándole meses de trabajo. Este episodio le hace <strong>tomar conciencia de la magnitud del cambio que se aproxima</strong>. A partir de ahí explica cómo trasladó esta preocupación a los investigadores principales de su centro. Les plantea que son uno de los centros de élite del planeta y que no pueden ignorar la nueva realidad.</p>

<blockquote>Mirad, el mundo se divide entre los que giran la cabeza y <strong>los que miran</strong> al problema o al cambio <strong>directo a los ojos</strong> y deciden qué hacer.</blockquote>

<p>Poco después, la frase con la que sintetiza su experiencia con la IA me ha dejado varios días reflexionando:</p>

<blockquote>Todos los humanos quieren vivir un momento singular en la historia de la humanidad. Pero es que creo que nos está tocando un <strong>momento singular en la historia</strong> de la humanidad, <strong>aquel en el que somos superados intelectualmente</strong>.</blockquote>

<p>No habrá sido la primera vez que has leído u oído una idea similar a esta, pero soy de la opinión de que no todas las opiniones tienen el mismo valor. Y esta, del científico José Ignacio Latorre, creo que está muy autorizada y es realmente relevante.</p>

<p>Así que ¡preparémonos para este apasionante momento de la historia de la humanidad!</p>

<p><img src="/img/inteligencia-artificial-mira-cambio-directamente-ojos-01.webp" loading="lazy" alt="Ilustración de una persona mirando frente a frente una red neuronal, representando la relación entre humanos e inteligencia artificial" width="750" height="422" /></p>]]></content><author><name>Aunitz Giménez</name></author><category term="inteligencia artificial" /><summary type="html"><![CDATA[Un físico teórico experto en inteligencia artificial nos ayuda a entender qué es la IA y cómo afrontarla sin miedo.]]></summary></entry><entry><title type="html">Lo que la inteligencia artificial nos enseña sobre qué es realmente la inteligencia</title><link href="https://www.aunitz.net/lo-que-inteligencia-artificial-nos-ensena-sobre-que-es-realmente-inteligencia/" rel="alternate" type="text/html" title="Lo que la inteligencia artificial nos enseña sobre qué es realmente la inteligencia" /><published>2026-05-31T19:00:00+02:00</published><updated>2026-05-31T19:00:00+02:00</updated><id>https://www.aunitz.net/lo-que-inteligencia-artificial-nos-ensena-sobre-que-es-realmente-inteligencia</id><content type="html" xml:base="https://www.aunitz.net/lo-que-inteligencia-artificial-nos-ensena-sobre-que-es-realmente-inteligencia/"><![CDATA[<div class="theconversation-article-body">

  <p><em><a href="https://theconversation.com/profiles/eva-aladro-vico-1231421" target="_blank" rel="noopener noreferrer">Eva Aladro Vico</a>, Catedrática de Teoría de la Información, <a href="https://theconversation.com/institutions/universidad-complutense-de-madrid-2383" target="_blank" rel="noopener noreferrer">Universidad Complutense de Madrid</a>. Este artículo fue publicado <a href="https://theconversation.com/lo-que-la-inteligencia-artificial-nos-ensena-sobre-que-es-realmente-la-inteligencia-202673" target="_blank" rel="noopener noreferrer">originalmente</a> el 10 de mayo de 2023 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

  <hr />

  <p>La llegada de la inteligencia artificial al público general ha supuesto el comienzo de un debate sobre si es posible que este sistema automático sustituya a la inteligencia humana. </p>

  <p>Múltiples autores, de <a href="https://www.nytimes.com/2023/03/08/opinion/noam-chomsky-chatgpt-ai.html" target="_blank" rel="noopener noreferrer">Noam Chomsky</a> a los <a href="https://www.unav.es/gep/AN/Aliseda.pdf" target="_blank" rel="noopener noreferrer">filósofos epistemólogos</a>, plantean una serie de dudas sobre este asunto: Chomsky detecta en ella la <a href="https://www.newtral.es/hannah-arendt-sobre-la-humanidad-del-mal/20191014/" target="_blank" rel="noopener noreferrer">banalidad del mal</a> de la filósofa Hannah Arendt, y otros consideran que no tiene capacidad para los <a href="http://www.commens.org/encyclopedia/article/fetzer-james-peirce-and-philosophy-artificial-intelligence" target="_blank" rel="noopener noreferrer">juicios abductivos</a> de nuestra mente, es decir, para la generación de nuevas lógicas en el progreso inesperado de la racionalidad.</p>

  <p>Muchos autores piensan que esta "inteligencia" está lejos de ser creativa, no es generativa, aunque sea capaz de producir textos nuevos en apariencia. Pero realmente, ¿qué diferencia la inteligencia artificial de la inteligencia humana, a secas?</p>

  <h2>Seleccionar, combinar y comparar</h2>

  <p>Los autores que estudian la inteligencia compositiva o sintética, que es la que puede generar nuevas ideas, tienen <a href="https://revistas.ucm.es/index.php/CIYC/article/download/CIYC0505110113A/7295/8222" target="_blank" rel="noopener noreferrer">establecido</a> que el cerebro humano que procesa información de modo inteligente y creativo realiza tres actividades diferentes: </p>

  <ol>
    <li><p><strong>Combinación selectiva:</strong> uniendo y combinando piezas informativas de modos específicos. Permite innovar cambiando el orden de los elementos, y muchas invenciones son resultado de una combinación o asociación innovadora, como la visión de la doble naturaleza del electrón. </p></li>
    <li><p><strong>Comparación selectiva:</strong> proyectando cadenas de asociaciones sobre nuevos contextos, para observar los paralelismos, es decir, realizando analogías y proyecciones metafóricas. Permite establecer paralelismos y lanzar hipótesis de unos campos a otros. Por ejemplo, ver la estructura molecular como una escalera de caracol o la del núcleo de un átomo como un pequeño sistema solar, comparaciones selectivas que generaron cruciales avances en el conocimiento.</p></li>
    <li><p><strong>Codificación selectiva:</strong> sintetizando, eliminando y puliendo las estructuras hasta que pierden ambigüedad y la información superflua. Este es el principio crucial en los avances inventivos y creadores en todos los campos. Por poner un ejemplo sencillo: Rembrandt renunció al uso de la gama del color azul en sus pinturas para potenciar la expresión con los otros colores; o Frank Capra recomendaba siempre eliminar rollos de película filmada para mejorar la calidad del conjunto.</p></li>
  </ol>

  <p>La inteligencia artificial usa toda la información que nosotros mismos volcamos a la red, realiza comparaciones y constantes combinaciones de elementos, siendo capaz de rastrear y presentar composiciones de cualquier tema o texto. El parecido con las operaciones creativas existe, pero hay una diferencia radical. ¿Cuál es?</p>

  <h2>Forma, elegancia y estética</h2>

  <p>El matemático francés <a href="https://es.wikipedia.org/wiki/Henri_Poincar%C3%A9" target="_blank" rel="noopener noreferrer">Henri Poincaré</a> llegó a la conclusión de que el acceso al conocimiento innovador no era una operación mecánica, ni tampoco provenía de la lógica racional. Acceder a una idea nueva, decía, era un "sentimiento de la forma" de esa innovación.  </p>

  <p>Según explica en su obra <a href="https://blogs.upm.es/nosolotecnica/2011/07/28/ciencia-y-metodo-henri-poincare-la-science-nest-pas-tout/" target="_blank" rel="noopener noreferrer"><em>Ciencia y Método</em></a>, cuando descubría soluciones en su búsqueda de avances matemáticos, experimentaba una impresión de forma, que iba inexorablemente unida al descubrimiento, y de cuya captación dependía el posterior desarrollo de todo el avance. </p>

  <p>Dicha experiencia podía considerarse estética, y Poincaré llegaba a experimentar la elegancia de la resolución de un problema matemático. ¿Qué quería decir Poincaré?</p>

  <h2>Salto al futuro</h2>

  <p>Los autores que estudian la inteligencia creadora efectivamente registran la paradoja de que cuando se crea una innovación en cualquier campo, se "saca de la nada" un conocimiento que antes no existía. Esta operación no puede generarse de modo automático, ni sistemático. Lo que hay en la invención creadora es un "salto al futuro" mediante un lenguaje nuevo, como explicaba <a href="https://es.wikipedia.org/wiki/Antoine_de_Saint-Exup%C3%A9ry" target="_blank" rel="noopener noreferrer">Antoine de Saint Exupéry</a> en sus <a href="https://editorialverbum.es/producto/cuadernos/" target="_blank" rel="noopener noreferrer"><em>Cuadernos</em></a>.</p>

  <p>Según Saint Exupéry, la relación entre elementos, que es anteriormente impensable e improbable, se construye mediante el lenguaje. Y esta operación es un fenómeno que los creadores ven ligado a la visión repentina de una forma, composición o estructura nuevas. Una vez se expresan y son compartidas, cambian radicalmente nuestra realidad. Pero no podemos planificar su aparición porque pertenecen al futuro que ellas mismas van creando.</p>

  <h2>El lenguaje cambiante</h2>

  <p>Sólo mediante un lenguaje capaz de combinaciones infinitas de elementos finitos, que puede romper sus propias normas y establecer o moldear nuevos elementos, es posible que se produzcan estos saltos. </p>

  <p>Según Poincaré y Saint Exupéry, entonces, la invención no es algo que resulte del compendio automático, ni del resumen de un conjunto profuso de datos, ni siquiera de la experiencia de aprendizaje previo. Se trata de algo diferente que está relacionado con un uso "disruptor" de los lenguajes y los códigos.</p>

  <p>Cuando un creador, un investigador o un científico innovan, no siguen patrones de uso habitual ni compilan la información universal. Su selección de elementos puede ser completamente inexplicable. Puede que incluso desconozcan información básica, y ello precisamente les sirva para innovar. Las analogías con las que trabajen pueden escapar de toda plausibilidad, pero sin embargo, serán como las de Galileo, imprescindibles. Y sus síntesis creativas seguramente serán al mismo tiempo nuevas y asombrosamente adecuadas. Ello forma parte del avance en el conocimiento, que no puede ser automatizado ni fabricado. </p>

  <p>En una muy reciente investigación, precisamente sobre <a href="https://www.nature.com/articles/s41586-022-05543-x" target="_blank" rel="noopener noreferrer">el declive de la expansión científica</a>, se percibe la desaparición significativa del uso de lenguajes disruptores en todos los campos del avance científico humano. </p>

  <h2>Trabajar con lo ya sabido</h2>

  <p>La inteligencia artificial no puede generar información nueva ni usar el lenguaje para generar nuevos pensamientos jamás concebidos por los seres humanos, porque su base de trabajo es lo "ya sabido", lo ya existente, la información universalmente compartida en la red. </p>

  <p>Es un excelente medio para procesar o difundir lo ya sabido, pero no para pensar lo nuevo. Está férreamente atada al pasado, y sus estructuras y códigos repiten y reiteran lo existente, lo previo.</p>

  <p>Estos sistemas pueden ayudar muchísimo para liberar a los informadores de tareas poco creativas e incluso puede que obligue a los profesionales a hacer algo más que repetir como loros la información convencional de fuentes ya conocidas.</p>

  <p>Si aprendemos a distinguir entre inteligencia artificial e inteligencia creadora quizás podamos también aprender con ello que muchas de las formas de comportamiento que hoy consideramos inteligentes no son más que simples ejercicios de redundancia, superficialidad e incluso estupidez. La inteligencia artificial puede enseñarnos esto, al menos.<!-- Below is The Conversation's page counter tag. Please DO NOT REMOVE. --><img src="https://counter.theconversation.com/content/202673/count.gif?distributor=republish-lightbox-basic" alt="The Conversation" width="1" height="1" style="border: none !important; box-shadow: none !important; margin: 0 !important; max-height: 1px !important; max-width: 1px !important; min-height: 1px !important; min-width: 1px !important; opacity: 0 !important; outline: none !important; padding: 0 !important" referrerpolicy="no-referrer-when-downgrade" /><!-- Fin del código. Si no ve ningún código arriba, por favor, obtenga el nuevo código de la pestaña Avanzado después de hacer clic en el botón de republicar. El contador de páginas no recoge ningún dato personal. Más información: http://theconversation.com/es/republishing-guidelines --></p>

  <hr />

  <p><em><a href="https://theconversation.com/profiles/eva-aladro-vico-1231421" target="_blank" rel="noopener noreferrer">Eva Aladro Vico</a>, Catedrática de Teoría de la Información, <a href="https://theconversation.com/institutions/universidad-complutense-de-madrid-2383" target="_blank" rel="noopener noreferrer">Universidad Complutense de Madrid</a>. Este artículo fue publicado <a href="https://theconversation.com/lo-que-la-inteligencia-artificial-nos-ensena-sobre-que-es-realmente-la-inteligencia-202673" target="_blank" rel="noopener noreferrer">originalmente</a> el 10 de mayo de 2023 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

</div>]]></content><author><name>Eva Aladro Vico</name></author><category term="inteligencia artificial" /><summary type="html"><![CDATA[La IA trabaja con información existente, pero la inteligencia creadora humana da saltos al futuro mediante lenguajes disruptivos.]]></summary></entry><entry><title type="html">Buenas prácticas de usabilidad para el chatbot de IA de tu sitio web</title><link href="https://www.aunitz.net/buenas-practicas-usabilidad-chatbot-ia-sitio-web/" rel="alternate" type="text/html" title="Buenas prácticas de usabilidad para el chatbot de IA de tu sitio web" /><published>2026-05-12T10:00:00+02:00</published><updated>2026-05-12T10:00:00+02:00</updated><id>https://www.aunitz.net/buenas-practicas-usabilidad-chatbot-ia-sitio-web</id><content type="html" xml:base="https://www.aunitz.net/buenas-practicas-usabilidad-chatbot-ia-sitio-web/"><![CDATA[<p>Proporcionar un <strong>chatbot de IA integrado en el sitio web</strong> se está convirtiendo en una <strong>funcionalidad estándar</strong> en numerosos sitios web o aplicaciones. Resulta fundamental ofrecer una buena experiencia de usuario para que los usuarios lo encuentren útil y quieran volver a utilizarlo.</p>

<p>En <a href="https://www.nngroup.com/" target="_blank" rel="noopener noreferrer">NN/Group</a> —prestigiosa agencia de expertos en UX— han publicado muy recientemente (abril del 2026) un interesante artículo con <a href="https://www.nngroup.com/articles/ai-chatbots-design-guidelines/" target="_blank" rel="noopener noreferrer">recomendaciones de usabilidad derivadas de la observación de personas usuarias reales interactuando con chatbots de IA</a> integrados en la web. Es decir, se trata de un <strong>estudio de campo</strong>, por lo que no se basa en suposiciones, sino en la <a href="/que-es-un-test-de-usabilidad-con-personas-usuarias/">observación real</a>. El artículo está firmado por <a href="https://www.nngroup.com/articles/author/georgia-kenderova/" target="_blank" rel="noopener noreferrer">Georgia Kenderova</a>, <a href="https://www.nngroup.com/articles/author/maria-rosala/" target="_blank" rel="noopener noreferrer">Maria Rosala</a> y <a href="https://www.nngroup.com/articles/author/tanner-kohler/" target="_blank" rel="noopener noreferrer">Tanner Kohler</a> y expone 10 buenas prácticas de usabilidad para chatbots de IA.</p>

<p>Dado el rigor y la profesionalidad que caracteriza los estudios de NN/Group, me ha parecido interesante hacerme eco de sus hallazgos y exponerlos en español (el artículo original está escrito en inglés). Además, para aportar valor añadido, los he ilustrado con capturas de pantalla o <em>wireframes</em> con ejemplos en español para acercar este interesante contenido al entorno hispanohablante. Y <strong>he añadido tres recomendaciones adicionales</strong> de cosecha propia que no se mencionan explícitamente en el artículo original.</p>

<h2>1. Deja claro desde el principio qué puede y qué no puede hacer el chatbot</h2>

<p>Cuando las personas usuarias lo abren por primera vez, <strong>el chatbot debería indicar de forma clara y concisa qué puede hacer</strong>.</p>

<p>Me parece uno de los puntos más importantes a tener en cuenta. ChatGPT y Gemini saben de todo y responden a cualquier pregunta que les hagamos. Salvo, quizás, para responder preguntas relacionadas con nuestro contenido propio. Con contenido exclusivo o específico de nuestro sitio web.</p>

<p>Los chatbots de IA integrados en un sitio web tienen un objetivo diferente a las IAs generalistas, el valor añadido que pueden ofrecer es resolver dudas o consultas específicas de nuestro contexto o negocio. Son chatbots que tienen acceso a nuestro contenido. Pero quizá no a todo él. O se encuentran limitados en algún área de conocimiento propia de nuestro contexto. Pero la persona usuaria no lo sabe, y es vital que le mostremos desde el principio <strong>qué tipo de dudas puede resolver nuestro chatbot</strong>.</p>

<p>Los saludos genéricos o la ausencia de sugerencias de preguntas no ajustan las expectativas de los usuarios y darán por supuesto que el chatbot puede resolverles cualquier tipo de consulta.</p>

<p>Por ejemplo, el mensaje inicial de la Administració Oberta de Catalunya es muy genérico.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-06.webp" loading="lazy" alt="Chatbot de la Administració Oberta de Catalunya con un saludo inicial genérico y sin sugerencias específicas de uso" width="750" height="480" /></p>

<p><strong>Indica en el mensaje introductorio los temas o tareas en los que el chatbot puede ayudar</strong>.</p>

<p>El asistente de la web del Gobierno de Grecia es también demasiado genérico.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-07.webp" loading="lazy" alt="Asistente digital mAigov de gov.gr con un mensaje inicial genérico: Good afternoon, how can I help you?" width="750" height="478" /></p>

<p>Un buen ejemplo lo tenemos en el chatbot de la Seguridad Social.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-08.webp" loading="lazy" alt="Asistente virtual de la Seguridad Social con botones de consulta sugeridos como Ingreso Mínimo Vital, Vida laboral y Pensión jubilación" width="750" height="436" /></p>

<p>Ahora bien, el mensaje inicial no debería abrumar con explicaciones detalladas, sino indicar de forma sencilla qué puede esperar el usuario. El caso de Iberia es un buen ejemplo en este sentido.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-09.webp" loading="lazy" alt="Chatbot IBot de Iberia con opciones iniciales claras para comprar vuelo, recomendar destino, ver reserva o hacer check-in" width="750" height="733" /></p>

<p>Si queremos ir a por nota, <strong>el mensaje inicial debería adaptarse a la página en la que se encuentra la persona usuaria</strong>. Es lo que hace Rufus, el asistente de IA de Amazon. La página de inicio me muestra unas sugerencias diferentes a la que se muestra en la página de un producto concreto como el Apple MacBook Neo.</p>

<div class="row">
    <div class="col-sm-6">
        <p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-10.webp" loading="lazy" alt="Rufus de Amazon en la página de inicio mostrando sugerencias generales agrupadas por temas" width="360" height="800" class="img-responsive" /></p>
    </div>
    <div class="col-sm-6">
        <p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-11.webp" loading="lazy" alt="Rufus de Amazon en una página de producto mostrando preguntas sugeridas relaciónadas con el artículo consultado" width="360" height="800" class="img-responsive" /></p>
    </div>
</div>

<h2>2. Mantén el chatbot accesible en todas las páginas</h2>

<p>Es un principio básico el <strong><a href="/principio-de-experiencia/">ser consistentes con el aprendizaje previo</a></strong> del usuario. Si le hemos acostumbrado a que el acceso al chatbot de nuestra web es un botón flotante en el extremo inferior derecho de la página, por ejemplo, no deberíamos hacerlo desaparecer en algunas secciones del sitio. Un chatbot que desaparece entre páginas es un chatbot que los usuarios acabarán dejando de utilizar.</p>

<p>En la web de Iberia tienen un chatbot de IA presente en casi todas las páginas del sitio web.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-02.webp" loading="lazy" alt="Página de Iberia con el chatbot IBot visible como widget flotante en la esquina inferior derecha" width="750" height="333" /></p>

<p>No así en el apartado de gestión de reservas.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-03.webp" loading="lazy" alt="Página de gestión de reservas de Iberia sin acceso visible al chatbot" width="750" height="422" /></p>

<p>Un hecho curioso, máxime teniendo en cuenta que el chatbot está diseñado precisamente para ayudar con la gestión de reservas.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-04.webp" loading="lazy" alt="Chatbot IBot de Iberia solicitando localizador y apellido para consultar una reserva" width="750" height="769" /></p>

<h2>3. Conserva el historial del diálogo entre todas las páginas</h2>

<p>Esta pauta no está incluida en el decálogo de NN/Group, pero me parece un requisito imprescindible. Imagina que estableces un diálogo con el chatbot y que en una de sus respuestas te ofrece un enlace interno a otra página del sitio. Lo esperable sería que, en la página de destino, el chatbot permaneciese abierto y conservase el historial de la conversación. Al menos durante la sesión vigente.</p>

<p>Afortunadamente, no es fácil encontrar ejemplos de chatbots que presenten este problema. Un caso es el de la Seguridad Social en España. En su chatbot, el historial de la conversación no solo se pierde cuando navegamos a otra página del sitio web, sino también, lo cual es aún peor, se pierde cada vez que cerramos la ventana del chatbot.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-05.gif" loading="lazy" alt="Animación del chatbot de la Seguridad Social perdiendo el historial de conversación al cerrar la ventana del asistente" width="750" height="401" /></p>

<h2>4. Un chatbot consciente del contexto ofrece respuestas mucho más relevantes</h2>

<p><strong>El chatbot debería conocer la página del sitio web en la que se encuentra el usuario</strong> y tenerla en cuenta si la pregunta que lanza el usuario está relacionada.</p>

<p>En Leroy Merlin, por ejemplo, si nos encontramos en una página de producto, el usuario esperaría que el chatbot fuese sensible al contexto. Pero no es así.</p>

<p><a href="/img/buenas-practicas-usabilidad-chatbot-ia-12-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/buenas-practicas-usabilidad-chatbot-ia-12.webp" loading="lazy" alt="Chatbot de Leroy Merlin en una página de mesa de jardín respondiendo que no puede ayudar con una pregunta sobre el peso del producto" width="750" height="348" /></a></p>

<p>Sin embargo, en Amazon, su chatbot responde en relación a la página de producto en la que nos encontramos.</p>

<div class="row">
    <div class="col-sm-6">
        <p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-13.webp" loading="lazy" alt="Página de producto de Amazon con un cargador Belkin, antes de consultar a Rufus sobre sus características" width="360" height="800" class="img-responsive" /></p>
    </div>
    <div class="col-sm-6">
        <p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-14.webp" loading="lazy" alt="Rufus de Amazon respondiendo cuánto pesa un cargador Belkin y ofreciendo preguntas de seguimiento relaciónadas" width="360" height="800" class="img-responsive" /></p>
    </div>
</div>

<h2>5. Ofrece preguntas sugeridas relevantes como botones, no como texto</h2>

<p>Hay dos momentos principales en los que los chatbots pueden mostrar sugerencias de preguntas:</p>

<ul>
    <li><strong>Cuando el usuario abre el chatbot por primera vez.</strong></li>
    <li><strong>Después de que el chatbot responda</strong>, especialmente si hay más información relevante que el usuario podría explorar.</li>
</ul>

<p><strong>Las sugerencias reducen el esfuerzo del usuario porque eliminan la necesidad de formular preguntas desde cero.</strong></p>

<p>Para facilitar su uso, <strong>las preguntas sugeridas deberían mostrarse como botones</strong> clicables y no como texto plano. Esto evita escritura innecesaria y permite ofrecer múltiples sugerencias sin resultar pesado con mucho texto.</p>

<p>Anteriormente hemos visto ejemplos de buenas preguntas o <strong>sugerencias de inicio</strong>. Por ejemplo, en la Seguridad Social.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-08.webp" loading="lazy" alt="Asistente virtual de la Seguridad Social con botones de consulta sugeridos como Ingreso Mínimo Vital, Vida laboral y Pensión jubilación" width="750" height="436" /></p>

<p>Las <strong>preguntas adicionales y relacionadas</strong> que el chatbot puede sugerir después de proporcionar una respuesta pueden ser muy útiles si son relevantes y no repetitivas.</p>

<p>Una participante en el estudio de NN/Group manifestó que le habían gustado mucho las preguntas de seguimiento porque le habían hecho reparar en cuestiones en las que no había pensado.</p>

<p>Un buen ejemplo son las <strong>preguntas de seguimiento</strong> que hace Rufus, el asistente de Amazon.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-15.webp" loading="lazy" alt="Rufus de Amazon respondiendo sobre la calidad de imagen de un MacBook y mostrando preguntas de seguimiento como botones" width="360" height="800" /></p>

<p>Las preguntas de seguimiento deberían responder al contexto de la conversación y no volver constantemente sobre temas que el usuario ya ha ignorado. Además, presentarlas como botones clicables hace mucho más sencillo continuar conversando.</p>

<p>En el siguiente ejemplo de Scouting America se echa en falta que las opciones de registro se presenten como botones y no en forma de pregunta en modo texto.</p>

<p><a href="/img/buenas-practicas-usabilidad-chatbot-ia-16-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/buenas-practicas-usabilidad-chatbot-ia-16.webp" loading="lazy" alt="Chatbot de Scouting America explicando las opciones de registro medíante texto en lugar de ofrecerlas como botones clicables" width="750" height="348" /></a></p>

<h2>6. Usa componentes expandibles para no abrumar con respuestas largas</h2>

<p>Las conversaciones con chatbots de IA pueden volverse largas rápidamente. En el artículo de NN/Group proponen mostrar la información adicional mediante componentes expandibles de tipo «acordeón». Sin embargo, no aportan ningún ejemplo de chatbot que aplique esta técnica. Por el contrario, mencionan el ejemplo de Rufus (el asistente de Amazon) que contiene enlaces de «más información» que en realidad lanzan una nueva pregunta al chatbot. Así comprobaron cómo los usuarios perdían el contexto y les resultaba difícil comparar opciones.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-19.gif" loading="lazy" alt="Animación de Rufus mostrando una respuesta larga con tarjetas de productos MacBook y enlaces de más información" width="380" height="844" /></p>

<h2>7. No hagas autoscroll hasta el final de la respuesta</h2>

<p>Algunos chatbots desplazan automáticamente la conversación hasta el final de las respuestas largas, obligando a los usuarios a volver hacia arriba para leer desde el principio.</p>

<p>Este comportamiento resulta especialmente confuso y molesto cuando el chatbot muestra la respuesta progresivamente mientras la genera.</p>

<p>El chat de Qwen lo hace así en estos momentos.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-20.gif" loading="lazy" alt="Animación de Qwen desplazando automáticamente la conversación hasta el final mientras genera una respuesta larga" width="750" height="508" /></p>

<p>Si una respuesta es más larga que el área visible del chat, <strong>mantén la posición del usuario al principio del nuevo mensaje en lugar de desplazarlo al final</strong>.</p>

<p>En sus inicios, ChatGPT también adolecía de este problema, pero actualmente ya lo han corregido.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-21.gif" loading="lazy" alt="Animación de ChatGPT manteniendo visible el inicio de una respuesta larga mientras se genera el contenido" width="750" height="508" /></p>

<h2>8. Incluye imágenes en las respuestas, no solo enlaces o descripciones textuales</h2>

<p>Los chatbots de IA están basados en los llamados LLM (Large Language Model) o modelos extensos de lenguaje. Es decir, <a href="/como-funciona-la-inteligencia-artificial-generativa/">trabajan con palabras</a>. Por eso, incluso en los productos punteros de IA, como ChatGPT o Gemini, la inclusión de imágenes en las respuestas es algo relativamente reciente. Sin embargo, a los humanos nos encantan las imágenes y nos ayudan "más que mil palabras" a entender ciertas respuestas.</p>

<p>Hay casos claros en los que las respuestas del chatbot se benefician enormemente si incluyen fotografías u otro tipo de elementos visuales. Por ejemplo, en la <strong>exploración de productos</strong> o en las <strong>instrucciones</strong> para aprender a utilizar una determinada herramienta.</p>

<p>Tenemos un buen ejemplo en el chatbot de Leroy Merlin.</p>

<p><a href="/img/buenas-practicas-usabilidad-chatbot-ia-17-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/buenas-practicas-usabilidad-chatbot-ia-17.webp" loading="lazy" alt="Chatbot de Leroy Merlin respondiendo a una consulta sobre pintura naranja con tarjetas de producto que incluyen fotografías y precios" width="750" height="348" /></a></p>

<p>En otro sitio web, a la misma pregunta sobre pintura naranja, la respuesta inicial es de solo texto.</p>

<p><a href="/img/buenas-practicas-usabilidad-chatbot-ia-18-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/buenas-practicas-usabilidad-chatbot-ia-18.webp" loading="lazy" alt="Chatbot de Lowe’s respondiendo a una consulta sobre pintura naranja con una lista textual de productos, sin imágenes visibles en la primera respuesta" width="750" height="482" /></a></p>

<p>Nota: en favor de esta web hay que decir que, inmediatamente después de esta respuesta, haciendo scroll, se muestran fotografías de los productos.</p>

<h2>9. Haz que el campo de texto crezca a medida que el usuario escribe</h2>

<p>Esta pauta no está incluida en el decálogo de NN/Group, pero me parece un requisito muy recomendable. Sabemos por la experiencia de muchos años de diseñar formularios que <a href="/formularios-usables-consejos-de-diseno/">el espacio disponible para escribir condiciona al usuario</a>. De modo que si el campo para escribir la petición o pregunta de la persona usuaria es reducido, desincentivará e incluso dificultará la escritura de <em>prompts</em> más extensos.</p>

<p><video src="/img/buenas-practicas-usabilidad-chatbot-ia-23.webm" width="834" height="248" autoplay="" loop="" muted="" playsinline="" title="Ejemplo de campo de texto de chatbot que mantiene una sola línea aunque el usuario escriba una consulta larga"></video></p>

<p>La solución es que <strong>el campo del <em>prompt</em> crezca progresivamente a medida que el usuario escribe</strong>.</p>

<p><video src="/img/buenas-practicas-usabilidad-chatbot-ia-24.webm" width="834" height="353" autoplay="" loop="" muted="" playsinline="" title="Ejemplo de campo de texto de chatbot que aumenta de altura progresivamente mientras el usuario escribe una consulta larga"></video></p>

<h2>10. Evita tener múltiples chatbots compitiendo por la atención del usuario</h2>

<p>Personalmente, no es un problema que me haya encontrado con frecuencia. En NN/Group, mencionan el caso del sitio web de Home Depot, que ofrece dos chatbots de IA que compiten entre sí por la atención del usuario. Tienen finalidades distintas, pero la persona usuaria no lo sabe de antemano. Obviamente no hay que hacer elegir al usuario entre múltiples chatbots diferentes. Si nuestra web ya cuenta con un chatbot, por ejemplo, para atención al cliente y queremos incorporar uno para resolver dudas sobre productos, <strong>deberemos combinarlos en un único chatbot</strong>.</p>

<p>Lo ideal es que haya un único chatbot claramente identificado que trate de resolver mediante IA todo lo que pueda y que escale las preguntas a humanos cuando sea necesario.</p>

<p>Me ha resultado difícil encontrar un ejemplo en español de este problema. Quizá el que más se asemeja es el caso de la web de PcComponentes, que llega a mostrar tres puntos de acceso diferentes a un mismo servicio de chatbot de IA.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-01.webp" loading="lazy" alt="Página de producto de PcComponentes con tres accesos visuales al asistente de IA: búsqueda superior, bloque promocional y botón flotante" width="750" height="654" /></p>

<p>Cuantas más opciones tenga el usuario a la vista, <a href="/unifica-funcionalidades-similares/">más le costará tomar una decisión</a>.</p>

<h2>11. Permite maximizar la ventana de chat</h2>

<p>El formato más extendido actualmente para mostrar un chatbot de IA integrado en la web es un widget flotante en el extremo inferior derecho de la ventana del navegador. Al clicar sobre él, se abre una pequeña ventana vertical superpuesta en la que se conversa con el chatbot. Como en el caso de la Administració Oberta de Catalunya.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-06.webp" loading="lazy" alt="Chatbot de la Administració Oberta de Catalunya con un saludo inicial genérico y sin sugerencias específicas de uso" width="750" height="480" /></p>

<p>En este tipo de interfaces, el espacio disponible puede ser reducido. Bien porque el usuario quiere extender la conversación y necesita un entorno más cómodo o bien porque las respuestas del bot se beneficiarían de una ventana de diálogo de mayor tamaño. Por ejemplo, si muestran respuestas enriquecidas con mapas, imágenes de producto, descripciones largas o listas extensas.</p>

<p>Una solución sencilla es incorporar un botón que permita maximizar la ventana del chatbot.</p>

<p><a href="/img/buenas-practicas-usabilidad-chatbot-ia-22-xl.webp" target="_blank" rel="noopener noreferrer"><img src="/img/buenas-practicas-usabilidad-chatbot-ia-22.webp" loading="lazy" alt="Chatbot de la Administració Oberta de Catalunya maximizado a pantalla completa para ofrecer más espacio de conversación" width="750" height="348" /></a></p>

<h2>12. Añade un botón para copiar la respuesta al portapapeles</h2>

<p>Hay ocasiones en las que el chatbot genera un contenido que el usuario puede querer consultar más adelante o compartirlo con alguien.</p>

<p>Los chats de IA más avanzados —ChatGPT, Gemini, etc.— ofrecen funcionalidades como compartir mediante un enlace, descargar a formatos como Word o <strong>copiar el contenido de una respuesta al portapapeles del sistema operativo</strong>. Precisamente esta última funcionalidad —botón de copiar la respuesta— es relativamente sencilla de implementar en el chatbot de IA de nuestra web y deberíamos incluirla. Sin embargo, es un patrón que aún no se encuentra muy extendido y es difícil encontrarlo en webs institucionales o <em>retail</em>.</p>

<p>Recientemente lo he planteado en el <em>wireframe</em> de la solución de <a href="https://www.adimedia.net/" target="_blank" rel="noopener noreferrer">Adimedia</a> de asistente IA.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-26.webp" loading="lazy" alt="Wireframe de un asistente de IA con el botón para copiar la respuesta al portapapeles resaltado" width="750" height="550" /></p>

<h2>13. No todos los usuarios quieren escribir: ofrece la opción de dictar los mensajes</h2>

<p>No todas las personas usuarias quieren escribir sus mensajes. Personalmente he observado que <strong>algunas personas</strong>, cuando utilizan un chatbot —en especial desde el móvil—, <strong>tienden de forma natural a dictar sus mensajes</strong>.</p>

<p>La entrada por voz es una funcionalidad muy recomendable. No tanto en el móvil, sino en especial en dispositivos de escritorio. En el móvil no es tan necesaria porque el propio sistema operativo permite dictar desde el teclado. Pero en equipos de escritorio la funcionalidad debería estar disponible. Como la tienen todos los "grandes jugadores" de IA.</p>

<p><img src="/img/buenas-practicas-usabilidad-chatbot-ia-25.webp" loading="lazy" alt="Campo de entrada de ChatGPT con el botón de dictado por voz resaltado" width="750" height="98" /></p>

<p>Estas han sido mis buenas prácticas de usabilidad para chatbots de IA. ¿Se te ocurre alguna más que debería incluir?👉 Te invito a proponerla en los <a href="https://www.linkedin.com/posts/aunitz_buenas-pr%C3%A1cticas-de-usabilidad-para-el-chatbot-share-7459971416323600384-3Xfw" target="_blank" rel="noopener noreferrer">comentarios de esta publicación en LinkedIn</a>.</p>]]></content><author><name>Aunitz Giménez</name></author><category term="buenas prácticas de usabilidad" /><category term="inteligencia artificial" /><summary type="html"><![CDATA[Cómo diseñar chatbots de IA en sitios web con buena usabilidad: 13 recomendaciones respaldadas por estudios de NN/Group.]]></summary></entry><entry><title type="html">La IA facilita (pero no garantiza) el aprendizaje en las organizaciones</title><link href="https://www.aunitz.net/ia-facilita-pero-no-garantiza-aprendizaje-en-organizaciones/" rel="alternate" type="text/html" title="La IA facilita (pero no garantiza) el aprendizaje en las organizaciones" /><published>2026-04-26T10:00:00+02:00</published><updated>2026-04-26T10:00:00+02:00</updated><id>https://www.aunitz.net/ia-facilita-pero-no-garantiza-aprendizaje-en-organizaciones</id><content type="html" xml:base="https://www.aunitz.net/ia-facilita-pero-no-garantiza-aprendizaje-en-organizaciones/"><![CDATA[<div class="theconversation-article-body">

  <p><em><a href="https://theconversation.com/profiles/jose-luis-alonso-andreano-1454244" target="_blank" rel="noopener noreferrer">Jose Luis Alonso Andreano</a>, Diseño de la estrategia, proyectos y programas de educación continua y lifelong learning, <a href="https://theconversation.com/institutions/mondragon-unibertsitatea-6043" target="_blank" rel="noopener noreferrer">Mondragon Unibertsitatea</a>. Este artículo fue publicado <a href="https://theconversation.com/la-ia-facilita-pero-no-garantiza-el-aprendizaje-en-las-organizaciones-272632" target="_blank" rel="noopener noreferrer">originalmente</a> el 20 de abril de 2026 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

  <hr />

  <p>La inteligencia artificial, en especial la generativa (IAG), ha entrado con fuerza en el aprendizaje en las organizaciones. Hoy, cualquier persona puede pedir en segundos a un asistente <em>chatbot</em> que explique una normativa, genere un plan de formación, resuma un informe técnico o proponga soluciones a un problema complejo.</p>

  <p>Las plataformas de aprendizaje <em>online</em> <a href="https://www.iseazy.com/es/blog/lms-vs-lxp/" target="_blank" rel="noopener noreferrer">ya incorporan IA</a> para personalizar itinerarios, recomendar contenidos y adaptar la experiencia formativa a las competencias, los objetivos y el contexto de cada profesional.</p>

  <p>Todo esto es real y supone una gran oportunidad. Varios <a href="https://degreed.com/experience/blog/ai-learning-revolution-is-here-most-companies-arent-ready/" target="_blank" rel="noopener noreferrer">informes</a> y <a href="https://joshbersin.com/2025/12/the-collapse-and-rebirth-of-online-learning-and-professional-development/" target="_blank" rel="noopener noreferrer">análisis</a> recientes describen una revolución del aprendizaje impulsada por la IA, aunque advierten de que la mayoría de las organizaciones todavía no están preparadas para aprovecharla. El problema no es sobrevalorar la tecnología, sino confundir el acceso al conocimiento con el aprendizaje.</p>

  <p>Aun con todas sus capacidades, la IA no está resolviendo la transferencia al trabajo real. Esa transferencia constituye la <em>última milla</em>: pasar de acumular conocimiento a tener un impacto real en las organizaciones.</p>

  <h2>El problema de las alucinaciones y la falsa experticia</h2>

  <p>Podríamos dejar al margen el debate sobre las llamadas "alucinaciones" de la IAG si no fuese por una cuestión. En la práctica, la creatividad, la utilidad percibida y la facilidad de uso <a href="https://irjbs.prasetiyamulya.ac.id/index.php/jurnalirjbs/article/view/545/180" target="_blank" rel="noopener noreferrer">pesan hoy más que la veracidad estricta de los resultados</a>. La IA suele generar respuestas claras, coherentes y bien redactadas, aunque a veces contengan errores.</p>

  <p>El riesgo aparece cuando una persona no domina el tema, porque esas respuestas pueden parecerle tan fiables como las de un experto. Ahí surge la <em>ilusión de comprensión</em>: la persona cree que tiene una buena respuesta y cree, además, que ha aprendido, cuando en realidad solo ha leído una explicación plausible que todavía no ha comprendido ni incorporado.</p>

  <p>No estaría demasiado lejos de lo que <a href="https://www.lavanguardia.com/cribeo/estilo-de-vida/20250425/10617309/poderosa-reflexion-daniel-kahneman-psicologo-premio-nobel-cuesta-admitir-errores-renunciar-seguridad-mmn.html" target="_blank" rel="noopener noreferrer">Daniel Kahneman describió como</a> el <em>falso experto</em>. Se observa, por ejemplo, en la programación asistida por IA (<em>vibe coding</em>), cuando una persona programa con ayuda de la herramienta <a href="https://www.enriquedans.com/2025/12/el-espejismo-del-vibe-coding-cuando-la-relajacion-progresiva-convierte-al-programador-en-espectador.html" target="_blank" rel="noopener noreferrer">sin comprender realmente qué hace el código</a>.</p>

  <p>El resultado puede ser un aumento aparente de la eficiencia, ya que se reduce el esfuerzo y se avanza más rápido, pero realmente existe un desconocimiento de lo que se está haciendo. Se toman decisiones sobre información que no se ha interiorizado y que difícilmente se podrá transferir a situaciones nuevas o imprevistas.</p>

  <p>Desde el punto de vista del aprendizaje, esto es crítico. Porque aprender no es reproducir una respuesta correcta con ayuda externa. Aprender implica comprender, integrar y ser capaz de aplicar ese conocimiento de manera autónoma en contextos distintos. Cuando la IAG acelera el resultado, pero debilita el proceso de reflexión, lo que genera es una falsa sensación de haber aprendido. Este fenómeno empieza ya a denominarse como "<a href="https://investigacion.udem.edu.mx/inteligencia-artificial-y-descarga-cognitiva-hacia-donde-nos-lleva-el-futuro/" target="_blank" rel="noopener noreferrer">descarga cognitiva</a>".</p>

  <h2>Pensar que el problema era el acceso al conocimiento</h2>

  <p>Durante años, muchas organizaciones partieron de una premisa: el problema era el acceso al conocimiento. Las direcciones de formación pensaban que las personas no aprendían porque faltaban recursos adecuados: la formación presencial era cara, interrumpía el trabajo y resultaba casi imposible llegar a toda la plantilla. La solución consistió en ampliar la oferta, digitalizarla y ponerla a disposición en cualquier momento y desde cualquier lugar. Esa lógica impulsó la proliferación de catálogos y plataformas; el problema desde entonces es que <a href="https://www.linkedin.com/pulse/breaking-down-online-course-completion-rates-insights-4qk7c/" target="_blank" rel="noopener noreferrer">la tasa de finalización de cursos <em>online</em> es de en torno al 10 %</a>.</p>

  <p>La IA ha llevado este enfoque al máximo. Hoy se pueden recomendar contenidos personalizados y ajustarlos de forma continua. La incorporación de la inteligencia artificial <a href="https://www.deloitte.com/uk/en/services/consulting/blogs/2024/ai-powered-employee-experience.html" target="_blank" rel="noopener noreferrer">impulsa el consumo, la finalización y la satisfacción en los procesos formativos</a>. Sin embargo, el acceso al conocimiento, por valioso que sea, no garantiza su transferencia efectiva al puesto de trabajo.</p>

  <p>Por tanto, el verdadero reto del aprendizaje en las organizaciones no está en saber más, sino en transferir el conocimiento a acciones en el día a día. Las barreras para ello son individuales, sociales y organizativas. Y la motivación, el tiempo y el contexto son los factores que más influyen en la transferencia.</p>

  <h2>Aprender es cambiar, y cambiar cuesta</h2>

  <p>Si entendemos el aprendizaje no como una acumulación de conocimiento sino como un cambio de comportamiento, duradero y transferible, el problema es otro. Las organizaciones no tienen tanto un problema de formación como un problema de aprendizaje. El mayor reto ya no es el acceso al conocimiento, sino cómo se gestionan las barreras que dificultan cambiar cómo se decide, cómo se colabora, cómo se lidera o cómo se prioriza, incluso cuando "se sabe" que debería hacerse de otra manera.</p>

  <p>La IA generativa puede sugerir opciones, simular escenarios y ayudar a preparar conversaciones difíciles. Sin embargo, el verdadero reto aparece cuando hay que tomar una decisión ambigua y arriesgada, cambiar un proceso o elegir una estrategia frente a otra. En esos momentos, el aprendizaje no lo determina la calidad del <em>prompt</em> ni del agente, sino la capacidad de decidir bajo incertidumbre y de asumir consecuencias. Las culturas que favorecen la experimentación y el aprendizaje facilitan esas decisiones. Las culturas que castigan el error y protegen el <em>statu quo</em> las vuelven casi imposibles.</p>

  <h2>Rediseñar el contexto</h2>

  <p>Parece evidente que la IA esta facilitando y acelerando el acceso al conocimiento. Sin embargo, el núcleo del problema no está en la herramienta. El trabajo principal sigue estando en el contexto, en la cultura de aprendizaje, en los incentivos para aprender, en el tiempo disponible, en el margen para experimentar y en la forma en que se toman decisiones. La dirección de las organizaciones no debería limitarse a <em>añadir IA</em>, sino que debería rediseñar las condiciones reales en las que las personas trabajan y aprenden, porque solo ahí se completa la transferencia.</p>

  <p>Esto implica pasar de la formación como consumo de contenidos a un aprendizaje ligado a proyectos reales, en los que el conocimiento se adquiere para resolver problemas concretos. Esto implica combinar la IA como asistente con espacios de reflexión compartida, en los que se extraen aprendizajes de las pruebas, aprendiendo de aquello que funciona y de lo que no. Esto implica, además, dejar de medir solo la actividad formativa y empezar a observar cambios en decisiones, comportamientos y resultados.</p>

  <p>Si queremos transformar las organizaciones y pasar de la formación al aprendizaje real, resulta imprescindible no solo acercar el conocimiento a las personas, sino cambiar las dinámicas que permitan aplicarlo en la <em>última milla</em>.<!-- Below is The Conversation's page counter tag. Please DO NOT REMOVE. --><img src="https://counter.theconversation.com/content/272632/count.gif?distributor=republish-lightbox-basic" alt="The Conversation" width="1" height="1" style="border: none !important; box-shadow: none !important; margin: 0 !important; max-height: 1px !important; max-width: 1px !important; min-height: 1px !important; min-width: 1px !important; opacity: 0 !important; outline: none !important; padding: 0 !important" referrerpolicy="no-referrer-when-downgrade" /><!-- Fin del código. Si no ve ningún código arriba, por favor, obtenga el nuevo código de la pestaña Avanzado después de hacer clic en el botón de republicar. El contador de páginas no recoge ningún dato personal. Más información: http://theconversation.com/es/republishing-guidelines --></p>

  <hr />

  <p><em><a href="https://theconversation.com/profiles/jose-luis-alonso-andreano-1454244" target="_blank" rel="noopener noreferrer">Jose Luis Alonso Andreano</a>, Diseño de la estrategia, proyectos y programas de educación continua y lifelong learning, <a href="https://theconversation.com/institutions/mondragon-unibertsitatea-6043" target="_blank" rel="noopener noreferrer">Mondragon Unibertsitatea</a>. Este artículo fue publicado <a href="https://theconversation.com/la-ia-facilita-pero-no-garantiza-el-aprendizaje-en-las-organizaciones-272632" target="_blank" rel="noopener noreferrer">originalmente</a> el 20 de abril de 2026 en <a href="https://theconversation.com" target="_blank" rel="noopener noreferrer">The Conversation</a> bajo licencia <a href="https://creativecommons.org/licenses/by-nd/4.0/" target="_blank" rel="noopener noreferrer">CC BY-ND 4.0</a>.</em></p>

</div>]]></content><author><name>Jose Luis Alonso Andreano</name></author><category term="inteligencia artificial" /><summary type="html"><![CDATA[La IA acelera el acceso al conocimiento en las organizaciones, pero no resuelve el reto de la transferencia al trabajo real.]]></summary></entry><entry><title type="html">Quiero que la IA me cite</title><link href="https://www.aunitz.net/quiero-que-la-ia-me-cite/" rel="alternate" type="text/html" title="Quiero que la IA me cite" /><published>2026-04-20T13:00:00+02:00</published><updated>2026-04-20T13:00:00+02:00</updated><id>https://www.aunitz.net/quiero-que-la-ia-me-cite</id><content type="html" xml:base="https://www.aunitz.net/quiero-que-la-ia-me-cite/"><![CDATA[<p>El pasado 11 de febrero tuve el placer de asistir al taller titulado <a href="https://enpresadigitala.spri.eus/es/seo-geo-como-ganar-visibilidad-organica-en-la-era-de-chatgpt/" target="_blank" rel="noopener noreferrer">"SEO + GEO: cómo ganar visibilidad orgánica en la era de ChatGPT"</a> impartido por <a href="https://www.linkedin.com/in/begolashayas/" target="_blank" rel="noopener noreferrer">Begoña Lashayas</a>, docente en Mondragon Unibertsitatea. La principal reflexión particular que extraigo de la jornada es que acaba de nacer una <strong>nueva especialidad en el ámbito del marketing digital</strong>: el <strong>GEO (Generative Engine Optimization)</strong>.</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-01.webp" loading="lazy" alt="Ilustración de una persona consultando un contenido citado en una pantalla de ordenador" width="750" height="353" /></p>

<p>Tengo compañeras y compañeros en <a href="https://www.adimedia.net/" target="_blank" rel="noopener noreferrer">Adimedia</a> que están especializados en marketing digital, pero en mi labor como director de proyectos digitales me gusta estar mínimamente al día de las novedades. Es el motivo que me ha impulsado a compartir en este artículo las principales ideas y reflexiones que extraigo del taller.</p>

<h2>Un cambio radical en el comportamiento de las personas usuarias</h2>

<p>Empecemos por tratar de definir qué es el GEO. De las definiciones alternativas que me ha facilitado Claude me quedo con la siguiente: <strong>conjunto de técnicas para maximizar la visibilidad y presencia de un contenido o marca en las respuestas generadas por motores de búsqueda basados en IA</strong> (como ChatGPT, Perplexity o Google AI Overviews). Ahora bien, debemos matizar que no se trata de "algo nuevo", sino más bien de <strong>una evolución del SEO</strong> (Search Engine Optimization) tradicional. <strong>Los principios que persigue el SEO ético</strong> —calidad, autoridad, relevancia— <strong>siguen siendo válidos para el GEO</strong>. Lo que cambia es el objetivo final. Con el SEO es aparecer bien posicionados en los resultados de los buscadores y captar tráfico cualificado, mientras que el objetivo del GEO es que <strong>nuestra web sea elegida como fuente de referencia</strong> por los modelos cuando un usuario realiza una consulta relacionada con su temática o sector. Dicho de otro modo, el objetivo del GEO es que <strong>los modelos de IA nos citen</strong>.</p>

<p>Lo que subyace al GEO es un <strong>cambio radical y muy profundo en el comportamiento de las personas usuarias</strong>. Durante muchos años, buscar información en internet ha consistido típicamente en introducir los <a href="/que-es-el-keyword-research/">términos de búsqueda en el buscador</a> (Google), analizar los primeros resultados que nos devuelve el motor de búsqueda y entrar en una o varias webs. Casi siempre hay, al menos, un clic. El <strong>buscador</strong> actúa como un <strong>intermediario</strong> que te lleva a otro sitio donde se encuentra la información. Este modelo de comportamiento no ha desaparecido, sigue existiendo, pero cada vez se está popularizando más otro modelo diferente. En lugar de buscar en Google le preguntamos directamente a la IA. Y <strong>la IA nos proporciona directamente la información que necesitamos</strong>. ChatGPT responde directamente. Google responde directamente (Google AI Overviews). El usuario no abandona el chatbot. No termina en ninguna web. Es lo que se conoce como el <strong>fenómeno zero-click</strong>.</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-02.webp" loading="lazy" alt="Ilustración de una persona comparando resultados de búsqueda tradicional y respuesta de IA" width="750" height="429" /></p>

<p>Realmente el fenómeno zero-click no es nuevo. Existe, desde hace muchos años, siempre que el usuario obtiene la respuesta que necesita directamente en la página de resultados del buscador mediante elementos como los fragmentos destacados (recuadros superiores que resumen la respuesta a una consulta), los paneles de conocimiento (información detallada en el lateral de la búsqueda) o las herramientas integradas (calculadoras, mapas, etc.). La novedad es que actualmente <strong>se está disparando el uso de las respuestas generadas por la IA</strong>. Tanto es así que, lo estamos viviendo en el día a día de nuestros clientes, <strong>el tráfico orgánico procedente de buscadores está cayendo de manera muy notable</strong>.</p>

<p>A pesar de todo ello, hay que tener muy presente que el modelo clásico de búsqueda no ha desaparecido y que <strong>el SEO tradicional sigue existiendo y sigue siendo importante</strong>. Y sus técnicas clave continúan teniendo que cuidarse con mimo:</p>

<ul>
    <li><strong>Palabras clave.</strong> Investigación y optimización de términos de búsqueda.</li>
    <li><strong>Contenidos.</strong> Creación de material relevante y de calidad.</li>
    <li><strong>Enlaces.</strong> Construcción de autoridad mediante backlinks.</li>
    <li><strong>Experiencia de usuario.</strong> Optimización de la navegación, la accesibilidad y la usabilidad.</li>
    <li><strong>Técnica.</strong> Optimización de velocidad, estructura y código.</li>
</ul>

<p><strong>El GEO no sustituye al SEO, son complementarios.</strong></p>

<h2>Objetivo adicional: ser fuente citada</h2>

<p>Ante el nuevo paradigma de comportamiento surge un nuevo objetivo de visibilidad que antes no existía: que la IA me utilice como fuente, me cite, me lea y me incorpore dentro de su respuesta, aunque el usuario no llegue nunca a mi página. Dicho de otro modo, <strong>cómo hago para que mi contenido sea parte de la respuesta</strong>.</p>

<p>Llegados a este punto me acuerdo de los inicios del SEO (sí, llevo muchos años en esto 😉): "se habla", "se dice", "se comenta"… El GEO es una disciplina que está arrancando. La IA evoluciona a una velocidad endiablada y lo que hoy se supone que es válido quizá no lo sea mañana. Por eso hay que tener claros ciertos principios y no fijarse tanto en la técnica, que irá evolucionando rápidamente. Retomo los principios del SEO ético: <strong>calidad, autoridad y relevancia</strong>. Creo que siguen siendo unos principios válidos también para el GEO.</p>

<h2>Un matiz importante: lo que la IA sabe vs. lo que la IA busca en internet</h2>

<p>Antes de continuar con las técnicas recomendables para mejorar el GEO, quiero introducir un matiz que es relevante para entender el funcionamiento de los modelos de IA.</p>

<p>Sabemos que los modelos de IA generativa generalistas han sido entrenados con infinidad de contenido universal. Ese contenido inmenso forma parte de lo que la IA "sabe". Es por ello que las primeras versiones de ChatGPT y otros modelos tenían una "fecha de corte" de su conocimiento y no eran capaces de contestar sobre acontecimientos o conocimientos generados posteriormente a esa fecha. En la actualidad esa limitación ha sido solventada porque los chatbots más avanzados <strong>son capaces de buscar en internet</strong> cuando se les hace una pregunta que no pueden contestar con su conocimiento interno. Y aquí es donde se encuentra el quid de la cuestión, ¿cómo ejecuta dicha búsqueda el modelo? ¿con qué resultados de la búsqueda se queda?</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-03.webp" loading="lazy" alt="Ilustración de documentos conectados a una red neuronal y a una lupa, representando visibilidad en IA" width="750" height="440" /></p>

<p>No hay una certeza absoluta sobre el mecanismo de búsqueda en internet que usan los modelos y además es algo que está en constante evolución. En el taller nos dijeron que la mayoría de los modelos utilizan los resultados de búsqueda de Google. Salvo excepciones como Microsoft Copilot, que usa Bing. Por tanto, el <strong>SEO tradicional</strong> sigue siendo importante para que pasemos el primer filtro: <strong>aparecer en los resultados que recibirá el modelo de IA</strong>. Ahora bien, hay una <strong>segunda parte</strong> del proceso que es aquella en la que <strong>el modelo selecciona</strong>, de entre las disponibles, algunos resultados y no otros para elaborar (sintetizar) su respuesta.</p>

<p>Sobre cómo mejorar nuestras opciones de ser seleccionados por la IA trata el siguiente apartado.</p>

<h2>Estrategias GEO</h2>

<p>En el taller se nos presentaron varias estrategias que podemos adoptar para mejorar el GEO. Algunas son más de principios —más atemporales— y otras más vinculadas al momento tecnológico actual.</p>

<h3>Estrategia 1: audita tu autoridad digital</h3>

<p>Se trata de una estrategia de evaluación. Queremos conocer qué nivel de autoridad nos atribuye la IA. Actualmente —seguro que surgirán mejores herramientas— el mecanismo es muy rudimentario. Se trata de lanzar una batería de preguntas sobre tu sector o ámbito de trabajo a 3 modelos de referencia. Por ejemplo, ChatGPT, Gemini y Perplexity.</p>

<p>Nota: para no contaminar con contexto propio al chatbot, ejecuta la batería de preguntas en sesiones anónimas del chatbot y en sus versiones gratuitas abiertas al público.</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-04.webp" loading="lazy" alt="Ilustración de una persona analizando varias respuestas de IA con una lupa" width="750" height="502" /></p>

<p>Analiza las respuestas:</p>

<ul>
    <li>¿Aparece tu sitio como fuente citada?</li>
    <li>¿En qué contextos apareces?</li>
    <li>¿Qué información extraen de ti?</li>
    <li>¿Te citan en temas donde eres experto?</li>
    <li>¿La información extraída es precisa?</li>
    <li>¿Hay información contradictoria?</li>
    <li>¿Quiénes aparecen citados en tus temas?</li>
    <li>¿Qué tienen ellos (competencia) que no tienes tú?</li>
</ul>

<p>Repite la misma batería de preguntas cada cierto tiempo (varias semanas o meses) y analiza la evolución. Ten en cuenta que los modelos de IA no contestan siempre lo mismo a la misma pregunta. Son sistemas no deterministas. Si te interesa el motivo de esta variabilidad, <a href="/es-la-inteligencia-artificial-generativa-una-caja-negra/">escribí un artículo que trata sobre el tema</a>.</p>

<h3>Estrategia 2: genera contenido original</h3>

<p>Los modelos de IA priorizan las fuentes primarias de contenido sobre el contenido derivado. Es por ello por lo que debes esforzarte en <strong>publicar contenido original y único</strong>. Como, por ejemplo:</p>

<ul>
    <li><strong>Investigaciones y estudios</strong>
        <ul>
            <li>Análisis de mercado propios</li>
            <li>Encuestas a usuarios/clientes</li>
            <li>Benchmarks de industria</li>
            <li>Análisis de tendencias con datos propios</li>
        </ul>
    </li>
    <li><strong>Datos cuantitativos</strong>
        <ul>
            <li>Estadísticas originales</li>
            <li>Métricas de rendimiento</li>
            <li>Comparativas con metodología transparente</li>
        </ul>
    </li>
    <li><strong>Perspectivas únicas</strong>
        <ul>
            <li>Casos de éxito documentados</li>
            <li>Lecciones de experiencia directa</li>
            <li>Insights de implementaciones reales</li>
        </ul>
    </li>
</ul>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-05.webp" loading="lazy" alt="Ilustración de un contenido destacado distribuyéndose hacia varios formatos y respuestas de IA" width="750" height="441" /></p>

<p>La calidad del contenido siempre ha sido relevante para el SEO. Para el GEO también, pero tiene algunos matices interesantes:</p>

<ul>
    <li>El texto de "relleno" no es bueno para el GEO, mientras que en el SEO es aceptable.</li>
    <li>La repetición de ideas dentro de un mismo contenido es aceptable en SEO. A los modelos de IA les gusta más el contenido bien estructurado semánticamente.</li>
</ul>

<h3>Estrategia 3: véndete</h3>

<p>Para que la IA te considere una fuente de <strong>autoridad</strong> le vendrá bien que expliques tus logros personales o los de tu organización. Me refiero a contenidos como:</p>

<ul>
    <li>Biografía detallada con experiencia y credenciales</li>
    <li>Apartado "Sobre nosotros"</li>
    <li>Publicaciones y contribuciones</li>
    <li>Apariciones en medios</li>
    <li>Aparición en fuentes de referencia. Como por ejemplo en la Wikipedia.</li>
    <li>Certificaciones relevantes</li>
    <li>Trayectoria documentada</li>
    <li>Enlaces a redes sociales activas</li>
</ul>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-06.webp" loading="lazy" alt="Ilustración de una página central conectada con varios resultados y fragmentos de contenido" width="750" height="375" /></p>

<h3>Estrategia 4: estructura tu contenido</h3>

<p>Esta estrategia se encuentra encaminada a facilitar al modelo que extraiga nuestro contenido. Para ello se pueden aplicar algunas técnicas.</p>

<h4>HTML semántico</h4>

<p>Nada nuevo bajo el sol. El HTML semántico (<code>article</code>, <code>header</code>, <code>section</code>, <code>time</code>, etc.) facilita al modelo que interprete correctamente nuestro contenido. Reduce la posible ambigüedad.</p>

<h4>Implementa Schema Markup (datos estructurados)</h4>

<p>Esta técnica tampoco es nueva. Tiene muchos años y <a href="https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data?hl=es-419" target="_blank" rel="noopener noreferrer">la recomienda Google para el SEO</a>. De nuevo SEO y GEO se complementan.</p>

<p>Se trata de código estandarizado —basado en el vocabulario de Schema.org— que se añade al HTML de una página para etiquetar y clasificar explícitamente el contenido, permitiendo que los motores de búsqueda y los modelos de IA identifiquen sin ambigüedad qué es cada elemento: un producto, una receta, un evento, una persona, un post, etc.</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-07.webp" loading="lazy" alt="Ilustración de contenido estructurado, código y tarjetas enriquecidas conectados entre si" width="750" height="312" /></p>

<p>Hay infinidad de tipos de datos estructurados. Puedes empezar por los más básicos:</p>

<ul>
    <li>Article, BlogPosting, NewsArticle</li>
    <li>FAQPage, HowTo</li>
    <li>Dataset (si publicas datos)</li>
    <li>Author (autoría)</li>
</ul>

<p>El marcado de autoría (autor) debe ser completo. Incluyendo, por ejemplo:</p>

<ul>
    <li>Nombre completo y cargo</li>
    <li>URL a perfil profesional</li>
    <li>Enlaces a redes (LinkedIn, X)</li>
</ul>

<p>Nota técnica: el <a href="https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data?hl=es-419" target="_blank" rel="noopener noreferrer">formato recomendado por Google</a> para los datos estructurados es JSON-LD.</p>

<h4>Estructura de contenido clara</h4>

<p>El contenido de la página debe tener una estructura clara. Tampoco son recomendaciones nuevas. Son las mismas técnicas que mejoran la legibilidad (experiencia de usuario) y el SEO. Como, por ejemplo:</p>

<ul>
    <li>Definiciones explícitas en primeros párrafos</li>
    <li>Listas y tablas (fáciles de extraer)</li>
    <li>Datos con fuente y metodología</li>
    <li>Secciones con headers semánticos claros</li>
</ul>

<h3>Estrategia 5: optimiza para fragmentos</h3>

<p>Va en la línea de darle "mascado" el contenido al modelo. Que tenga ya "empaquetada" la respuesta. A esta técnica se le denomina <strong>"answer block"</strong>. Consiste en redactar respuestas a preguntas específicas en bloques autocontenidos de entre 50 y 100 palabras que, al no depender de ningún contexto previo, ofrecen información completa y precisa en un formato fácilmente extraíble por motores de búsqueda e IA generativa, maximizando así las posibilidades de ser seleccionados como respuesta directa.</p>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-08.webp" loading="lazy" alt="Ilustración de una página web cuyo contenido pasa a un asistente conversacional" width="750" height="398" /></p>

<p>❌ Ejemplo de mal bloque (no extraíble)</p>

<blockquote>
    <p>Como explicamos antes, esto depende de varios factores que ya vimos. Si lo combinas con las otras técnicas, funciona bastante bien según el caso.</p>
</blockquote>

<p>✅ Ejemplo de buen bloque (extraíble)</p>

<blockquote>
    <p>El Schema Markup es un código estandarizado que se añade al HTML de una página. Etiqueta el contenido para que los motores de búsqueda e IA identifiquen con precisión cada elemento: producto, evento u organización. Implementarlo aumenta la probabilidad de aparecer en rich results y de ser citado por la IA como fuente de referencia.</p>
</blockquote>

<h4>La técnica estrella de esta estrategia: las FAQ</h4>

<p>Supuestamente las estructuras de contenidos en forma de preguntas y respuestas les encantan a los modelos de IA porque les facilitan todo lo que necesitan. Es el motivo por el que habrás observado que los apartados de FAQ están empezando a proliferar en todo tipo de webs.</p>

<p>He de confesar que es una técnica que me genera dudas, porque veo que precisamente se está extendiendo tanto su uso que, si todo el mundo termina por utilizarla, al final no resulte eficaz para diferenciarte del resto de webs de tu competencia.</p>

<h3>Estrategia 6: consistencia y actualización</h3>

<p>De nuevo se trata de una estrategia clásica del mundo SEO. Asegura la consistencia de tus contenidos y actualiza contenido regularmente.</p>

<p>Los modelos de IA son muy buenos detectando inconsistencias. Así como información desactualizada, publicaciones sin fecha ni fuente, etc.</p>

<h2>Conclusión</h2>

<p>A modo de conclusión o de resumen final me gustaría poner el foco en que el nuevo paradigma de SEO + GEO se basa en:</p>

<ul>
    <li>Mantén el trabajo de <strong>SEO tradicional</strong>. No nos olvidemos del SEO.</li>
    <li>Trabaja la <strong>semántica</strong>. Mediante HTML semántico, datos estructurados, etc.</li>
    <li>Trabaja la <strong>autoridad</strong>. Genera contenido único y habla desde la experiencia.</li>
</ul>

<p><img src="/img/quiero-que-la-ia-me-cite-geo-09.webp" loading="lazy" alt="Ilustración de tres columnas SEO y GEO como pilares de visibilidad digital" width="750" height="511" /></p>]]></content><author><name>Aunitz Giménez</name></author><category term="inteligencia artificial" /><category term="SEO/GEO" /><category term="marketing" /><summary type="html"><![CDATA[Qué es el GEO (Generative Engine Optimization) y cómo aplicar sus estrategias para que la IA te cite como fuente de referencia.]]></summary></entry><entry><title type="html">Los cinco niveles de adopción de la IA en el desarrollo de software</title><link href="https://www.aunitz.net/cinco-niveles-adopcion-ia-en-desarrollo-software/" rel="alternate" type="text/html" title="Los cinco niveles de adopción de la IA en el desarrollo de software" /><published>2026-04-15T14:00:00+02:00</published><updated>2026-04-15T14:00:00+02:00</updated><id>https://www.aunitz.net/cinco-niveles-adopcion-ia-en-desarrollo-software</id><content type="html" xml:base="https://www.aunitz.net/cinco-niveles-adopcion-ia-en-desarrollo-software/"><![CDATA[<p>En los últimos años, el emprendedor Dan Shapiro se ha convertido en una voz influyente en el ámbito de la IA generativa. Recientemente, el 23 de enero de 2026, ha propuesto un <a href="https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/" target="_blank" rel="noopener noreferrer">modelo de madurez de cinco niveles para el desarrollo de software asistido por IA</a> que ha tenido bastante repercusión; o, más bien, de seis, ya que está indexado desde cero.</p>

<p><img src="/img/cinco-niveles-adopcion-ia-en-desarrollo-software-01.webp" loading="lazy" alt="Ilustración de una persona pasando de escribir código a dirigir un resultado, representando la evolución en el uso de IA" width="720" height="330" /></p>

<p>Me ha parecido interesante porque describe un proceso de <strong>transición</strong> de los desarrolladores <strong>desde un rol de ejecutor a uno de gestor</strong>. Un planteamiento que va en la misma línea de lo que han identificado Martin Fowler y el resto de los participantes en el retiro sobre el futuro del desarrollo de software en Utah el pasado mes de febrero y del que <a href="/como-sera-futuro-ingenieria-software-en-era-ia/">escribí un post recientemente</a>.</p>

<p>Los niveles propuestos por el modelo, desde el punto de vista de los desarrolladores, son los siguientes:</p>

<ul>
  <li><strong>Nivel 0: <em>Spicy Autocomplete</em>.</strong> Hacer consultas básicas a herramientas como ChatGPT. Aceptar sugerencias simples de autocompletado; el código es 100% del humano.</li>
  <li><strong>Nivel 1: <em>The Coding Intern</em>.</strong> Se delegan tareas puntuales y específicas (como escribir un test unitario o un comentario) que requieren una revisión humana completa. Utilizan el asistente de código integrado dentro del editor o IDE.</li>
  <li><strong>Nivel 2: <em>The Junior Developer</em>.</strong> Programación en pareja ("pair programming") donde la IA se encarga de las partes aburridas y repetitivas, pero el humano sigue revisando cada línea.</li>
  <li><strong>Nivel 3: <em>The Developer</em>.</strong> El humano <strong>no escribe el código</strong>. Proporciona las instrucciones para que el agente lo escriba y el humano lo revisa. Te pasas los días revisando código. Muchísimo código. Llegados a este nivel, hay desarrolladores que sienten que su situación ha empeorado con respecto a los niveles anteriores.</li>
  <li><strong>Nivel 4: <em>The Engineering Team</em>.</strong> El humano asume el rol de Project Manager (PM). Escribe especificaciones y planes, discute con la IA sobre ellos y deja que los agentes trabajen durante horas antes de verificar si los tests pasan.</li>
  <li><strong>Nivel 5: <em>The Dark Software Factory</em>.</strong> El proceso de desarrollo de software se convierte en una "caja negra" que transforma especificaciones directamente en software funcional sin intervención humana. En este nivel, <strong>nadie lee nunca el código generado</strong> por la IA; el enfoque humano se centra en diseñar el sistema y en herramientas de simulación y pruebas para asegurar que funciona.</li>
</ul>

<p><img src="/img/cinco-niveles-adopcion-ia-en-desarrollo-software-02.webp" loading="lazy" alt="Ilustración de una persona conectando un documento con un sistema de IA y una interfaz de resultado" width="720" height="321" /></p>

<p>En el —muy recomendable— <a href="https://webreactiva.substack.com/p/los-agentes-de-ia-mienten-pero-nosotros" target="_blank" rel="noopener noreferrer">podcast de Daniel Primo (Web Reactiva)</a> se hicieron eco de este modelo de niveles de adopción y lanzaron una encuesta entre los oyentes que arrojó los siguientes resultados:</p>

<p><img src="/img/cinco-niveles-adopcion-ia-en-desarrollo-software-03.svg" loading="lazy" alt="Gráfico de encuesta sobre fases de adopción de IA en desarrollo de software, con mayor porcentaje en la fase No escribo el código" width="720" height="450" /></p>

<p>Los participantes en el episodio (<a href="https://www.linkedin.com/in/danielprimo/" target="_blank" rel="noopener noreferrer">Daniel Primo</a> y <a href="https://jmgomez.dev/" target="_blank" rel="noopener noreferrer">José Manuel Gómez</a>) se sitúan a sí mismos en una transición entre los niveles 4 y 5, dependiendo de la responsabilidad del proyecto. Sus niveles 4 y 5 se corresponden en realidad con los niveles 3 y 4 del modelo de Dan Shapiro. Es decir, que <strong>han dejado de escribir código de forma manual</strong> en gran parte de su flujo de trabajo. En resumen, ya no "pican" código línea a línea como antes, sino que actúan como gestores de una fábrica de software donde su principal herramienta es el <strong>criterio</strong> y el <strong>diseño de instrucciones</strong>.</p>

<p>Conviene matizar que estos niveles no son necesariamente lineales ni universales: según el tipo de proyecto y la responsabilidad implicada, uno puede moverse entre varios de ellos de forma simultánea.</p>

<p>👉 Si quieres compartir el punto en el que tú te encuentras, te invito a hacerlo en los <a href="https://www.linkedin.com/posts/aunitz_%F0%9D%90%8B%F0%9D%90%A8%F0%9D%90%AC-%F0%9D%90%9C%F0%9D%90%A2%F0%9D%90%A7%F0%9D%90%9C%F0%9D%90%A8-%F0%9D%90%A7%F0%9D%90%A2%F0%9D%90%AF%F0%9D%90%9E%F0%9D%90%A5%F0%9D%90%9E%F0%9D%90%AC-%F0%9D%90%9D%F0%9D%90%9E-%F0%9D%90%9A%F0%9D%90%9D%F0%9D%90%A8%F0%9D%90%A9%F0%9D%90%9C%F0%9D%90%A2%F0%9D%90%A8%F0%9D%90%A7-share-7450198780303429632-vId5" target="_blank" rel="noopener noreferrer">comentarios de esta publicación en LinkedIn</a>.</p>]]></content><author><name>Aunitz Giménez</name></author><category term="inteligencia artificial" /><category term="desarrollo de soluciones digitales" /><summary type="html"><![CDATA[Dan Shapiro propone un modelo de cinco niveles de adopción de la IA en el desarrollo de software, del autocompletado a la fábrica autónoma.]]></summary></entry></feed>